Dentro de um arquivo PDF tem um saco de objetos numerados e um índice no fim que anota o deslocamento em bytes de cada um. Os objetos pequenos são dicionários, vetores, nomes e números, legíveis o bastante num editor de texto; os pesados são fluxos comprimidos com as fontes, as imagens e as instruções de desenho de cada página. Nada ali dentro é uma foto de uma página, e nada está em ordem de leitura: o leitor abre o arquivo pelo fim, acha o índice, desce pela árvore de páginas e só então executa as instruções que pintam a página que você pediu.
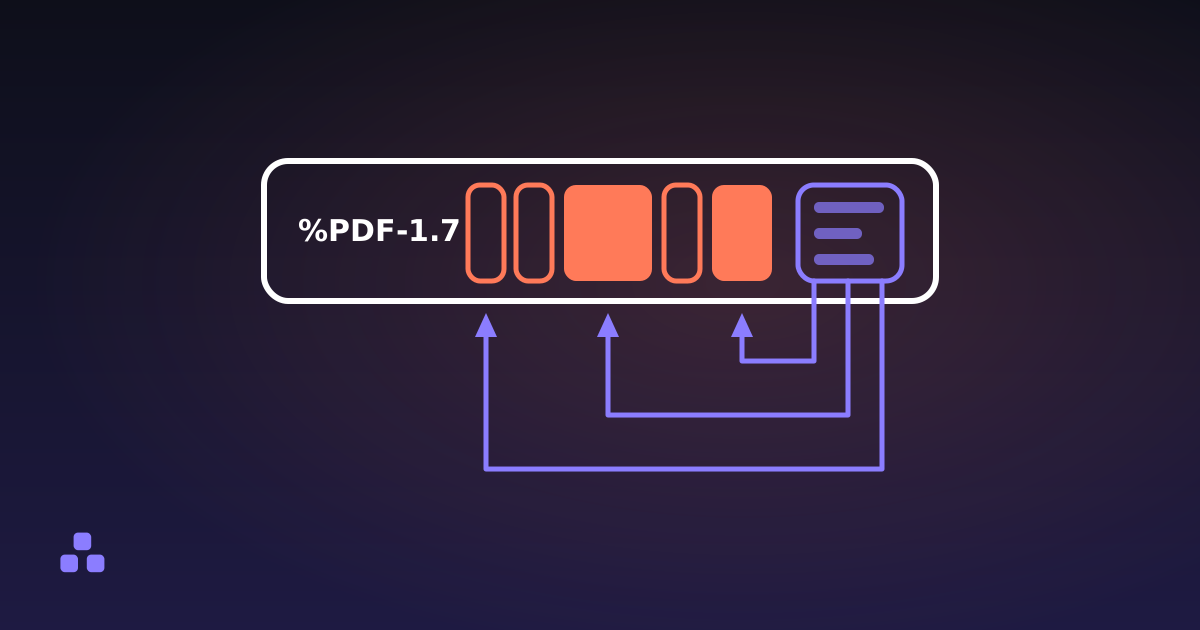
Todo PDF tem as mesmas quatro partes, nesta ordem:
- Um cabeçalho. Uma linha,
%PDF-1.7ou parecida, que nomeia a versão. - Um corpo. Os objetos numerados: a árvore de páginas, as fontes, as imagens, os fluxos de conteúdo.
- Uma tabela de referências cruzadas. O índice, que lista o deslocamento em bytes de cada objeto.
- Um trailer. Nomeia o catálogo, e depois dele vêm o deslocamento da tabela e
%%EOF.
Como é um objeto dentro de um PDF?
Abra um PDF num editor de texto puro e, embaixo do %PDF-1.7 da primeira linha, você vai encontrar blocos como este entre trechos de ruído binário: menos deles num arquivo recente, que empacota quase todos os objetos em fluxos comprimidos. O de baixo é uma única página:
3 0 obj
<< /Type /Page
   /Parent 2 0 R
   /MediaBox [0 0 595.28 841.89]
   /Rotate 0
   /Resources << /Font << /F1 7 0 R >> >>
   /Contents 4 0 R
>>
endobj
Esse é o objeto número 3, geração 0. Os dois sinais de ângulo marcam um dicionário, as palavras que começam com barra são nomes, e 2 0 R é uma referência a outro objeto: o pai desta página na árvore de páginas. A página em si não guarda quase nada: um tamanho de folha, uma rotação, as fontes e imagens que ela tem permissão de usar, e um ponteiro para o objeto 4, onde ficam as marcas sobre o papel. O formato inteiro é montado com um punhado de tipos: números, cadeias, nomes, vetores, dicionários e streams: um dicionário com uma fileira de bytes grudada atrás.
Como o leitor acha alguma coisa no arquivo?
Lendo de trás para frente. A última linha é %%EOF, acima dela estão startxref e um deslocamento em bytes, e esse deslocamento aponta para a tabela de referências cruzadas: uma lista dizendo que o objeto 1 começa no byte 15 e o objeto 2 no byte 178. Ao lado da tabela fica o trailer, que nomeia o catálogo do documento, a raiz da qual todo o resto pende. É por isso que um manual de 900 páginas consegue abrir na página 900 sem decodificar as 899 anteriores. Desde o PDF 1.5 esse índice muitas vezes é um fluxo comprimido em vez de uma tabela legível: o mesmo trabalho, só que sem nada para ler.
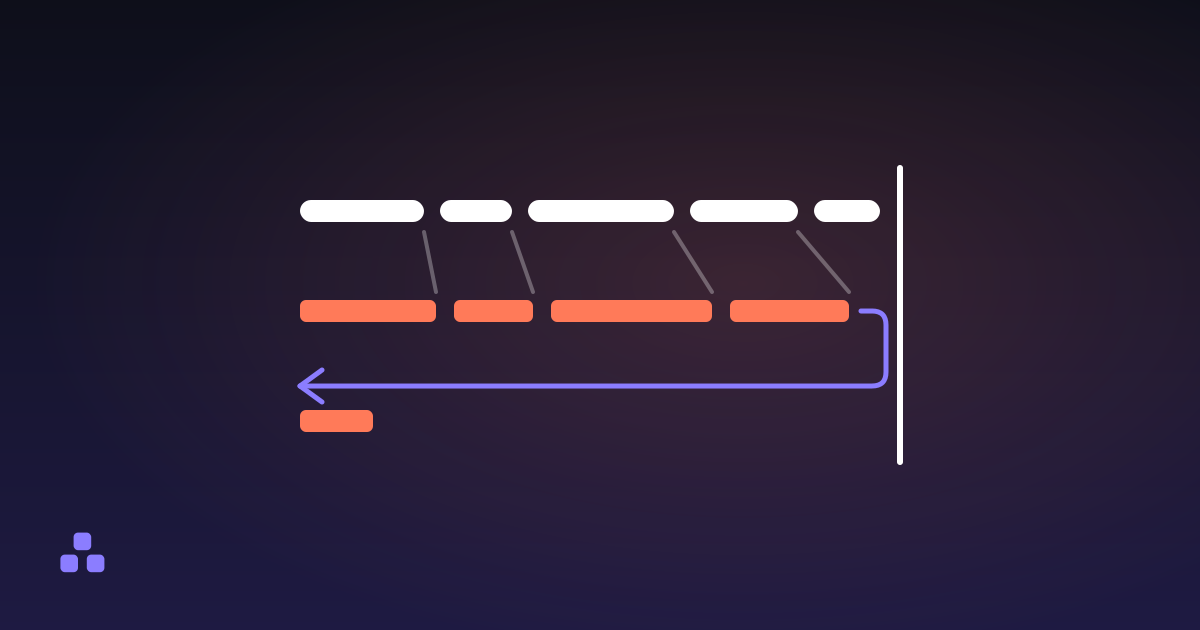
Esse também é o ponto fraco do formato. Os deslocamentos são posições absolutas em bytes, então qualquer coisa que reescreva o arquivo sem reescrever a tabela quebra tudo, e scanners, preenchedores de formulário e bibliotecas de exportação baratas erram com frequência suficiente para que todo leitor sério carregue uma rotina de reparo. Quando a tabela não leva a lugar nenhum, o leitor varre o arquivo atrás de cabeçalhos obj e reconstrói o índice com o que encontra. Um arquivo assim normalmente abre bem, e está a uma cópia descuidada de não abrir mais.
A outra coisa escondida lá atrás é o histórico. Salvar uma alteração não obriga a reescrever o arquivo: o programa pode acrescentar os objetos alterados no fim com uma tabela nova que aponta para a antiga. O que parece um documento pode ser quatro gerações de edições empilhadas, com as versões anteriores ainda presentes nos bytes. É assim que um arquivo chega ao destino carregando um rascunho anterior de si mesmo, e é por isso que apagar páginas de um PDF para que sumam de verdade é uma operação diferente de fazer com que elas parem de aparecer.
Onde estão as páginas e por que cada uma tem o próprio tamanho?
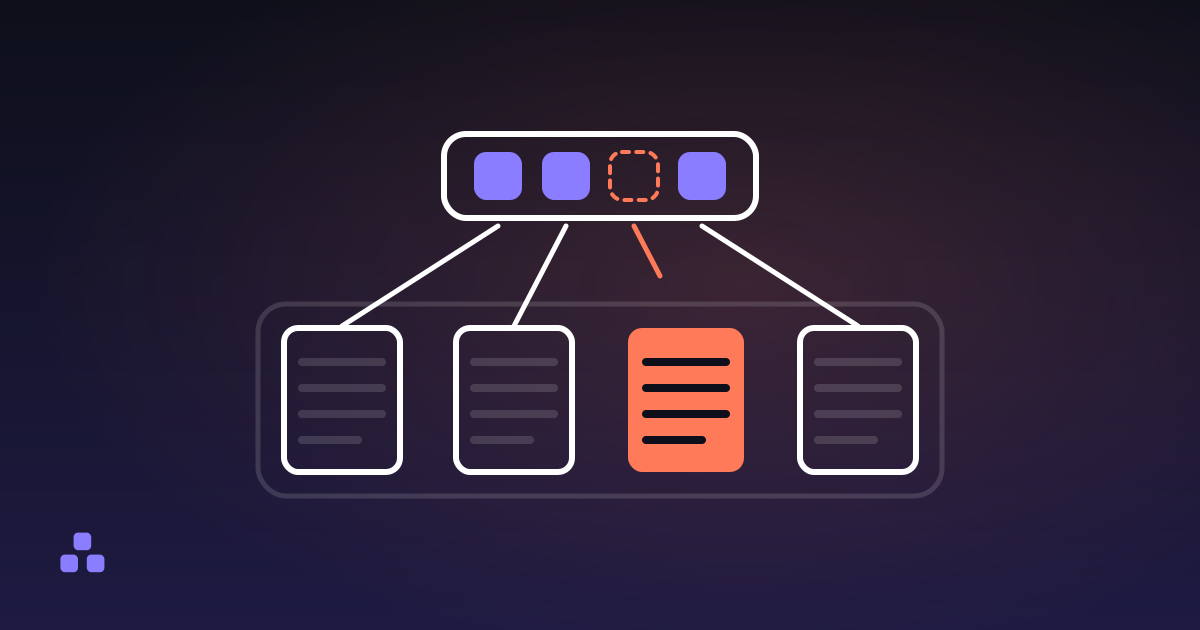
O catálogo aponta para uma árvore de páginas: um nó com um vetor /Kids cujos filhos são outros nós ou páginas de verdade. Os atributos descem pela árvore, então um documento pode declarar o tamanho da folha uma vez só no topo e deixar cada página herdar, até que uma página sobrescreva o valor, que é o que acontece quando um documento é montado a partir de mais de uma fonte.
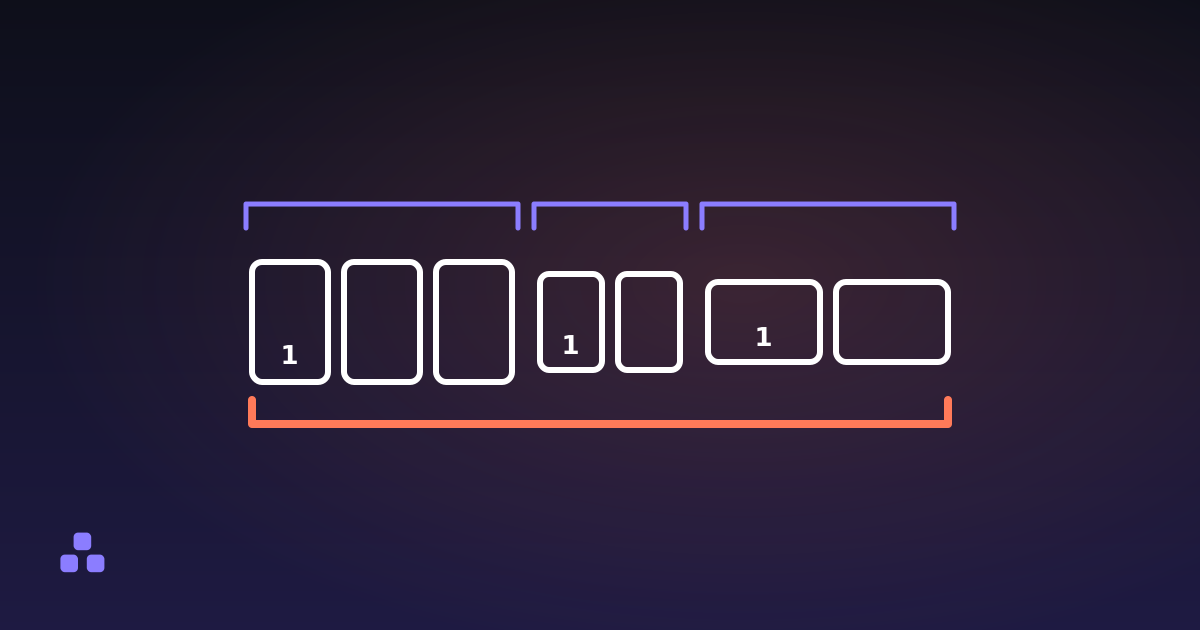
A geometria da página é guardada em pontos, a 72 pontos por polegada, num vetor /MediaBox que dá os cantos da folha. O A4 sai como 595.28 × 841.89 porque é nisso que dá 210 × 297 mm; o US Letter é um redondo 612 × 792. Esses números não são uma sugestão para a impressora, são a página. Uma página Letter dentro de um relatório A4 imprime escalada, deslocada ou puxada de outra bandeja, e nada na tela diz qual página foi. Ler os tamanhos resolve: o que um PDF diz sobre cada uma das suas páginas agrupa as páginas em faixas e marca toda página cujo tamanho de folha não bate com o da maioria, então as emendas aparecem como linhas a mais.
Há outras duas entradas por página que causam problema fora de proporção. /CropBox é a região que o visualizador exibe; quando ela é menor que o MediaBox a página parece cortada, mas nada foi removido, e o conteúdo de fora volta na hora em que alguém aumenta a caixa. /Rotate é um único número — qualquer múltiplo de 90, que os leitores reduzem aos quatro ângulos que significam alguma coisa — aplicado na hora de exibir a página em vez de ficar gravado no conteúdo, e é por isso que girar um PDF para que ele continue girado é instantâneo até numa digitalização de 400 MB.
O que tem de fato num fluxo de conteúdo?
Instruções, escritas em ordem postfixa e quase sempre comprimidas com Flate. Descomprimida, uma linha de texto fica mais ou menos assim: BT /F1 12 Tf 72 720 Td (Hello) Tj ET, ou seja, começar texto, usar a fonte F1 a 12 pontos, mover para esta coordenada, mostrar estes glifos, terminar texto. Não existe parágrafo, não existe linha, não existe ordem de leitura e não existe noção de palavra. O arquivo registra que um glifo foi pintado numa posição; você conseguir ler uma frase é um efeito colateral de as posições fazerem sentido.
As reclamações de sempre sobre PDF vêm daí. O texto copiado chega com as colunas embaralhadas, porque nada jamais disse qual coluna vinha primeiro. O espaço entre duas palavras muitas vezes não é um caractere, e sim um pequeno movimento horizontal, então uma frase que você vê nem sempre é uma que uma busca consegue achar. E um retângulo preto desenhado sobre um nome é mais uma instrução de desenho, pintada por cima do texto: o texto continua no fluxo, continua selecionável, continua extraível. Tarjar de verdade é remover os glifos, não cobri-los.
O que os metadados dizem e o que eles entregam?
Eles moram em dois lugares, e se contradizem com mais frequência do que você gostaria. O dicionário Info clássico carrega Title, Author, Subject, Keywords, Creator, Producer e duas datas, escritas no formato de data do próprio PDF — D:20240115103000+01'00' —, que inclui o fuso horário configurado na máquina. A maioria dos arquivos modernos carrega também um pacote XMP, um bloco XML guardado como um stream próprio, e um título mudado em um lugar e não no outro é um jeito rotineiro de ser pego.
Creator e Producer são confundidos o tempo todo. Creator é o programa onde o conteúdo foi escrito: Word, InDesign, o software de um scanner. Producer é a biblioteca que escreveu os bytes do PDF, e é o mais revelador dos dois: Acrobat, Ghostscript, um "imprimir em PDF" do navegador ou o script de alguém. O campo Author muitas vezes não passa do nome da conta que salvou o arquivo, e é assim que rascunhos internos chegam a clientes com o nome completo de alguém colado. Tudo isso é texto livre colocado por software, então leia como uma afirmação e não como um fato — e leia antes de mandar o arquivo, não depois.
Por que editar um PDF não redesenha nada?
Quando as páginas são objetos numa árvore, as operações do dia a dia deixam de ser edições de um documento e viram cirurgia num grafo. Girar uma página muda um número. Apagar uma remove uma entrada de um vetor /Kids. Dividir é ficar com um subconjunto das páginas e os recursos para os quais elas apontam, e juntar PDFs sem enviá-los para lugar nenhum é copiar dois grafos de objetos para dentro de um mesmo arquivo, renumerando pelo caminho, e escrever uma árvore de páginas nova por cima. Nada disso redesenha coisa alguma, e é por isso que esses trabalhos são rápidos, sem perda e perfeitamente possíveis numa aba do navegador.
Isso também explica a decepção de sempre: um arquivo juntado quase nunca pesa menos que a soma das partes, porque a mesma fonte acaba embutida duas vezes, e dividir um arquivo de 10 MB raramente dá duas metades de 5 MB, porque as duas levam junto recursos que o documento compartilhava.
Se você quer ver algo disso num arquivo que já tem, o inspetor de PDF deste site lê a árvore de páginas, os tamanhos, a rotação e os metadados no seu navegador e mostra o que o arquivo afirma sobre si mesmo, sem enviar nada para lugar nenhum. Três coisas que ele não faz: desenhar as páginas, extrair o texto e ler o bloco XMP. Ele informa o dicionário Info clássico, então um título que aparece vazio ali pode continuar existindo na cópia XML.
E se o arquivo nasceu em outro lugar, o que quer que o tenha escrito decidiu quase toda a estrutura que você acabou de ler. O que muda quando um documento do Word vira PDF cobre quais dessas peças são escritas e qual parte da sua formatação não sobrevive à viagem.
Perguntas frequentes
O que tem dentro de um arquivo PDF?
Uma linha de cabeçalho, um corpo de objetos numerados, uma tabela de referências cruzadas listando o deslocamento em bytes de cada objeto e um trailer apontando para o catálogo do documento. O catálogo leva a uma árvore de páginas, e cada página aponta para um fluxo de conteúdo com instruções de desenho mais as fontes e imagens que ela usa. Nada é guardado como uma imagem da página nem em ordem de leitura.
Dá para abrir um PDF num editor de texto?
Em parte. Num arquivo antigo ou pouco comprimido, o cabeçalho, os dicionários de objetos e a tabela de referências cruzadas são ASCII legível, então você consegue ver os tamanhos de página e os metadados com qualquer editor. Os fluxos de conteúdo, as fontes e as imagens são binário comprimido e saem como ruído. Arquivos mais novos vão além e empacotam quase todos os objetos, e o próprio índice, em fluxos comprimidos, e aí sobra muito pouco legível.
Por que o texto copiado de um PDF sai embaralhado?
Porque um PDF guarda glifos em coordenadas, não frases. Nada no arquivo registra a ordem de leitura, então um layout de duas colunas não tem como dizer qual vem primeiro, e o espaço entre palavras costuma ser um movimento de posição em vez de um caractere de espaço. As ferramentas de extração adivinham a ordem pela geometria, e num layout complexo elas adivinham errado.
Quais metadados um PDF contém?
Título, autor, assunto, palavras-chave, o aplicativo que criou o conteúdo, a biblioteca que escreveu o arquivo e as datas de criação e modificação com fuso horário. Muitos arquivos carregam uma segunda cópia disso num bloco XMP que pode não bater com a primeira. É tudo texto livre escrito por software, então trate como uma afirmação e não como um fato, e confira antes de mandar o arquivo.
O texto escondido embaixo de uma tarja preta num PDF sumiu mesmo?
Não. A tarja preta é uma instrução de desenho pintada por cima do texto, e o texto continua embaixo, no fluxo de conteúdo, onde qualquer ferramenta de extração vai achar. O mesmo vale para uma página cortada: uma caixa de corte menor que a folha esconde o conteúdo sem removê-lo. Tarjar de verdade apaga os glifos do fluxo.
Última atualização 21 de setembro de 2026