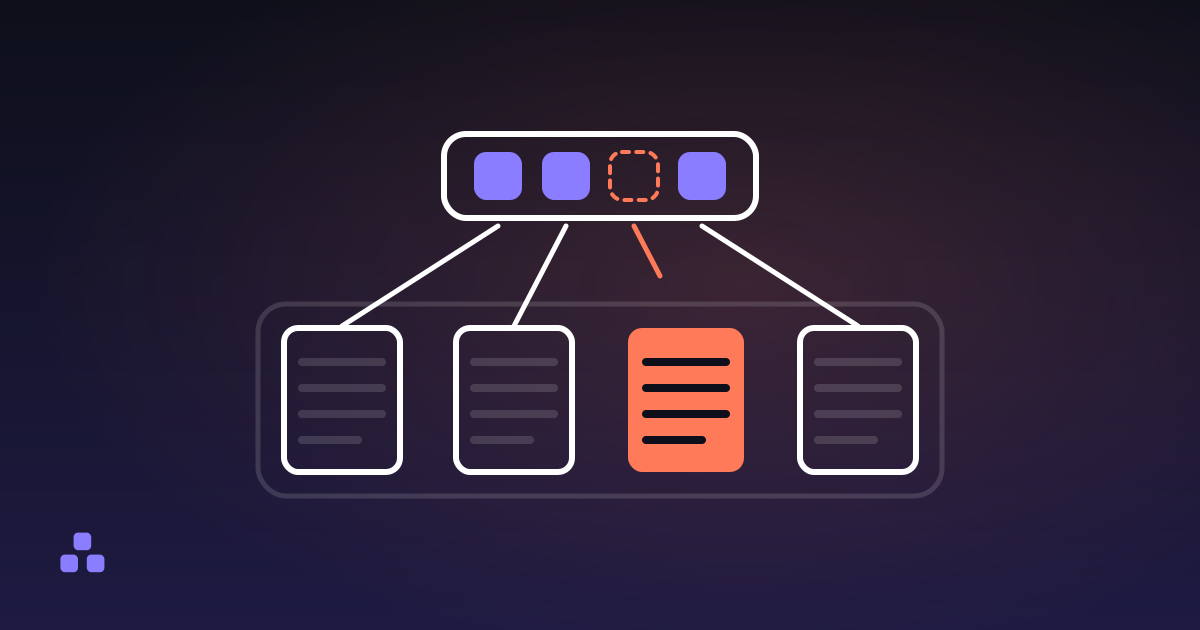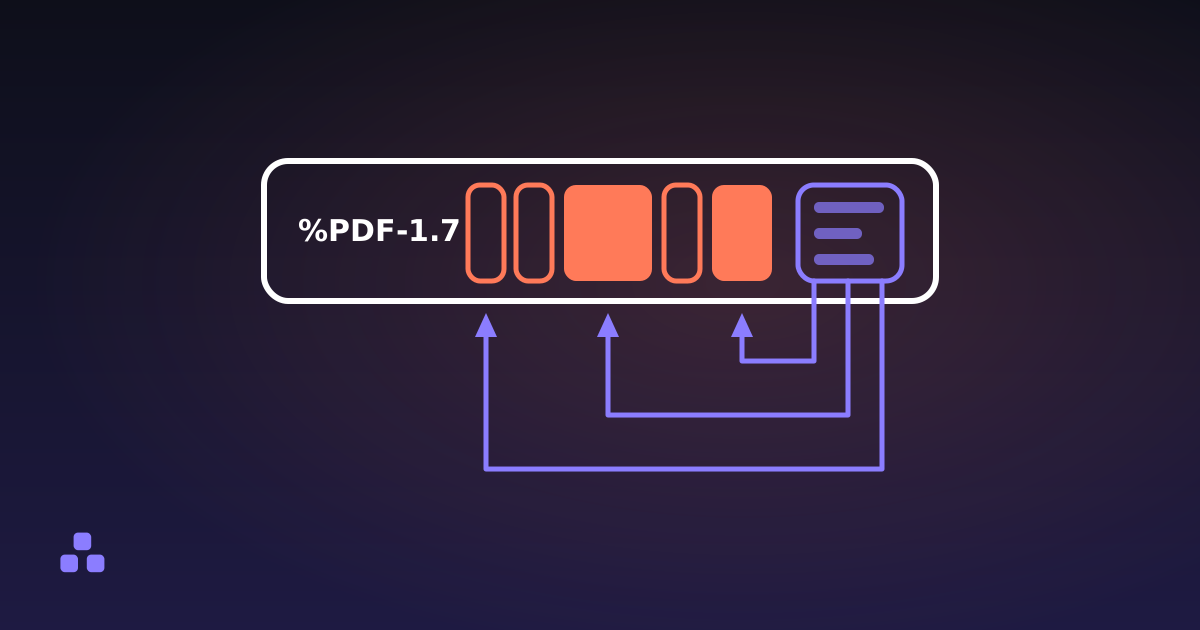
Adentro de un archivo PDF hay una bolsa de objetos numerados y un índice al final que anota el desplazamiento en bytes de cada uno. Los objetos chicos son diccionarios, arreglos, nombres y números, bastante legibles en un editor de texto; los pesados son flujos comprimidos con las fuentes, las imágenes y las instrucciones de dibujo de cada página. Nada ahí adentro es una foto de una página, y nada está en orden de lectura: el lector abre el archivo por atrás, encuentra el índice, baja por el árbol de páginas y recién entonces ejecuta las instrucciones que pintan la página que pediste.
Todo PDF tiene las mismas cuatro partes, en este orden:
- Una cabecera. Una línea,
%PDF-1.7o parecida, que nombra la versión. - Un cuerpo. Los objetos numerados: el árbol de páginas, las fuentes, las imágenes, los flujos de contenido.
- Una tabla de referencias cruzadas. El índice, que lista el desplazamiento en bytes de cada objeto.
- Un tráiler. Nombra el catálogo, y lo siguen el desplazamiento de la tabla y
%%EOF.
¿Cómo se ve un objeto adentro de un PDF?
Abre un PDF en un editor de texto plano y, debajo del %PDF-1.7 de la primera línea, vas a encontrar bloques como este entre tramos de ruido binario: menos de ellos en un archivo reciente, que empaqueta casi todos los objetos en flujos comprimidos. El de abajo es una sola página:
3 0 obj
<< /Type /Page
   /Parent 2 0 R
   /MediaBox [0 0 595.28 841.89]
   /Rotate 0
   /Resources << /Font << /F1 7 0 R >> >>
   /Contents 4 0 R
>>
endobj
Ese es el objeto número 3, generación 0. Los dos ángulos marcan un diccionario, las palabras que empiezan con barra son nombres, y 2 0 R es una referencia a otro objeto: el padre de esta página en el árbol de páginas. La página en sí no guarda casi nada: un tamaño de hoja, una rotación, las fuentes e imágenes que tiene permitido usar, y un puntero al objeto 4, donde están las marcas sobre el papel. Todo el formato se arma con un puñado de tipos: números, cadenas, nombres, arreglos, diccionarios y streams: un diccionario con una tira de bytes pegada atrás.
¿Cómo encuentra el lector algo en el archivo?
Leyéndolo al revés. La última línea es %%EOF, encima están startxref y un desplazamiento en bytes, y ese desplazamiento apunta a la tabla de referencias cruzadas: una lista que dice que el objeto 1 empieza en el byte 15 y el objeto 2 en el byte 178. Al lado de la tabla está el tráiler, que nombra el catálogo del documento, la raíz de la que cuelga todo lo demás. Por eso un manual de 900 páginas puede abrirse en la página 900 sin decodificar las 899 anteriores. Desde PDF 1.5 ese índice muchas veces es un flujo comprimido en vez de una tabla legible: el mismo trabajo, pero sin nada que leer.
Ese es también el punto débil del formato. Los desplazamientos son posiciones absolutas en bytes, así que cualquier cosa que reescriba el archivo sin reescribir la tabla la rompe, y los escáneres, los rellenadores de formularios y las bibliotecas de exportación baratas se equivocan lo bastante seguido como para que todo lector serio lleve una rutina de reparación. Cuando la tabla no lleva a ningún lado, el lector recorre el archivo buscando cabeceras obj y reconstruye el índice con lo que encuentra. Un archivo así abre bien casi siempre, y está a una copia descuidada de no abrir nunca más.
La otra cosa escondida ahí atrás es la historia. Guardar un cambio no obliga a reescribir el archivo: el programa puede agregar los objetos modificados al final con una tabla nueva que apunta a la vieja. Lo que parece un documento pueden ser cuatro generaciones de ediciones apiladas, con las versiones anteriores todavía presentes en los bytes. Así es como un archivo llega a destino cargando un borrador anterior de sí mismo, y por eso borrar páginas de un PDF para que se vayan de verdad es una operación distinta de hacer que dejen de aparecer.
¿Dónde están las páginas y por qué cada una tiene su propio tamaño?
El catálogo apunta a un árbol de páginas: un nodo con un arreglo /Kids cuyos hijos son otros nodos o páginas de verdad. Los atributos bajan por el árbol, así que un documento puede declarar el tamaño de hoja una sola vez arriba y dejar que cada página lo herede, hasta que una página lo sobrescribe, que es lo que pasa cuando un documento se arma con más de una fuente.
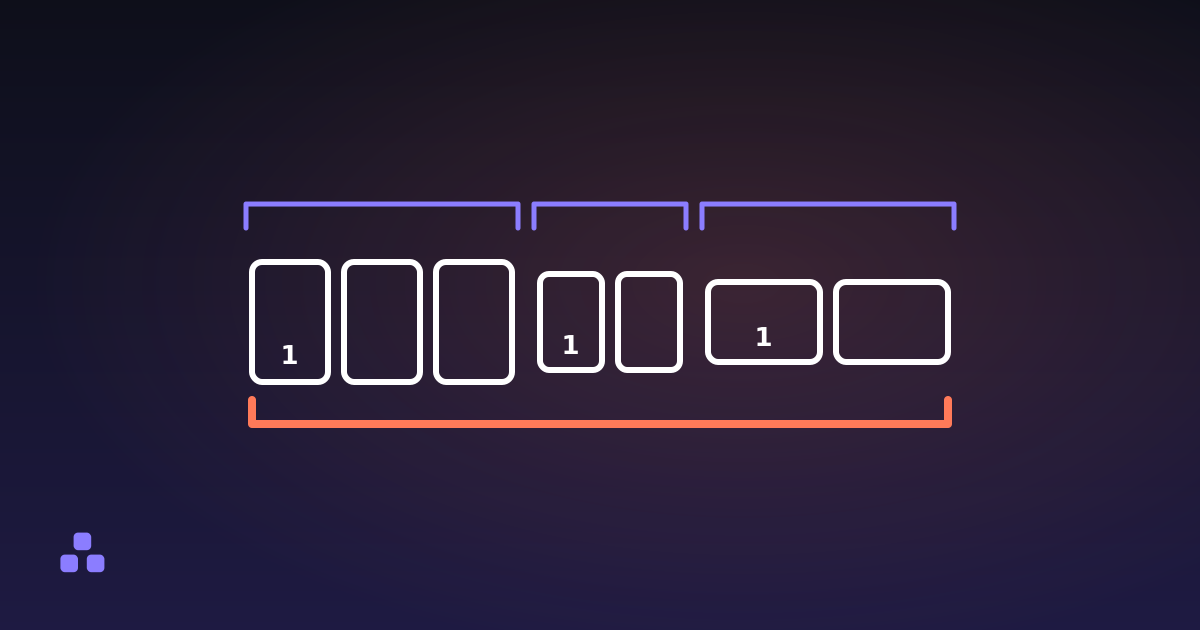
La geometría de la página se guarda en puntos, a 72 puntos por pulgada, en un arreglo /MediaBox que da las esquinas de la hoja. A4 queda en 595.28 × 841.89 porque eso es lo que dan 210 × 297 mm; US Letter es un redondo 612 × 792. Esos números no son una sugerencia para la impresora, son la página. Una página Letter dentro de un informe A4 sale escalada, corrida o desde otra bandeja, y nada en la pantalla te dice cuál fue. Leer los tamaños es la solución: lo que un PDF dice de cada una de sus páginas las agrupa en rangos y marca toda página cuyo tamaño de hoja no coincide con el de la mayoría, así las costuras aparecen como líneas de más.
Hay otras dos entradas por página que causan problemas desproporcionados. /CropBox es la región que muestra el visor; cuando es más chica que el MediaBox la página parece recortada, pero no se eliminó nada, y el contenido de afuera vuelve apenas alguien agranda la caja. /Rotate es un solo número —cualquier múltiplo de 90, que los lectores reducen a los cuatro ángulos que significan algo— y se aplica al mostrar la página en vez de quedar grabado en el contenido, y por eso girar un PDF para que se quede girado es instantáneo incluso en un escaneo de 400 MB.
¿Qué hay realmente en un flujo de contenido?
Instrucciones, escritas en orden postfijo y casi siempre comprimidas con Flate. Descomprimida, una línea de texto se ve más o menos así: BT /F1 12 Tf 72 720 Td (Hello) Tj ET, es decir, empezar texto, usar la fuente F1 a 12 puntos, moverse a esta coordenada, mostrar estos glifos, terminar texto. No hay párrafo, no hay línea, no hay orden de lectura y no hay noción de palabra. El archivo anota que se pintó un glifo en una posición; que puedas leer una oración es un efecto secundario de que las posiciones sean razonables.
De ahí salen las quejas de siempre sobre los PDF. El texto copiado llega con las columnas entremezcladas, porque nada dijo nunca qué columna iba primero. El espacio entre dos palabras muchas veces no es un carácter sino un pequeño movimiento horizontal, así que una frase que ves no siempre es una que una búsqueda pueda encontrar. Y un rectángulo negro dibujado sobre un nombre es una instrucción de dibujo más, pintada encima del texto: el texto sigue en el flujo, sigue siendo seleccionable, sigue siendo extraíble. Tachar de verdad es eliminar los glifos, no taparlos.
¿Qué dicen los metadatos y qué revelan?
Viven en dos lugares, y no coinciden tan seguido como te gustaría. El diccionario Info clásico lleva Title, Author, Subject, Keywords, Creator, Producer y dos fechas, escritas en el formato de fecha propio del PDF —D:20240115103000+01'00'—, que incluye el huso horario que tenía configurado la máquina. La mayoría de los archivos modernos lleva además un paquete XMP, un bloque XML guardado como un stream propio, y un título cambiado en un lado y no en el otro es una forma habitual de quedar en evidencia.
Creator y Producer se confunden todo el tiempo. Creator es el programa donde se escribió el contenido: Word, InDesign, el software de un escáner. Producer es la biblioteca que escribió los bytes del PDF, y es el más revelador de los dos: Acrobat, Ghostscript, un "imprimir a PDF" del navegador o el script de alguien. El campo Author muchas veces no es más que el nombre de la cuenta que guardó el archivo, y así es como los borradores internos llegan a los clientes con el nombre completo de alguien encima. Todo eso es texto libre puesto por el software, así que léelo como una afirmación y no como un hecho, y léelo antes de mandar el archivo, no después.
¿Por qué editar un PDF no vuelve a dibujar nada?
Cuando las páginas son objetos en un árbol, las operaciones de todos los días dejan de ser ediciones de un documento y pasan a ser cirugía sobre un grafo. Girar una página cambia un número. Borrar una quita una entrada de un arreglo /Kids. Dividir es quedarse con un subconjunto de las páginas y los recursos a los que apuntan, y unir PDF sin subirlos a ningún lado es copiar dos grafos de objetos dentro de un mismo archivo, renumerando sobre la marcha, y escribir un árbol de páginas nuevo por encima. Nada de eso vuelve a dibujar nada, y por eso estos trabajos son rápidos, sin pérdida y perfectamente posibles en una pestaña del navegador.
También explica la decepción de siempre: un archivo unido casi nunca pesa menos que la suma de sus partes, porque la misma fuente queda incrustada dos veces, y dividir un archivo de 10 MB rara vez da dos mitades de 5 MB, porque las dos se llevan recursos que el documento compartía.
Si quieres ver algo de esto en un archivo que tienes a mano, el inspector de PDF de este sitio lee el árbol de páginas, los tamaños, la rotación y los metadatos en tu navegador y te muestra lo que el archivo afirma sobre sí mismo, sin subirlo a ningún lado. Tres cosas que no hace: dibujar las páginas, extraer el texto y leer el bloque XMP. Informa el diccionario Info clásico, así que un título que ahí aparece vacío puede seguir estando en la copia XML.
Y si el archivo nació en otra parte, lo que sea que lo escribió decidió casi toda la estructura que acabas de leer. Qué cambia cuando un documento de Word se convierte en PDF repasa cuáles de estas piezas se escriben y qué parte de tu formato no sobrevive el viaje.
Preguntas frecuentes
¿Qué hay adentro de un archivo PDF?
Una línea de cabecera, un cuerpo de objetos numerados, una tabla de referencias cruzadas que lista el desplazamiento en bytes de cada objeto y un tráiler que apunta al catálogo del documento. El catálogo lleva a un árbol de páginas, y cada página apunta a un flujo de contenido con instrucciones de dibujo más las fuentes e imágenes que usa. Nada se guarda como una imagen de la página ni en orden de lectura.
¿Se puede abrir un PDF en un editor de texto?
En parte. En un archivo viejo o poco comprimido, la cabecera, los diccionarios de objetos y la tabla de referencias cruzadas son ASCII legible, así que puedes ver los tamaños de página y los metadatos con cualquier editor. Los flujos de contenido, las fuentes y las imágenes son binario comprimido y salen como ruido. Los archivos más nuevos van más lejos y empaquetan casi todos los objetos, y el índice mismo, en flujos comprimidos, y ahí queda muy poco legible.
¿Por qué el texto copiado de un PDF sale desordenado?
Porque un PDF guarda glifos en coordenadas, no oraciones. Nada en el archivo registra el orden de lectura, así que una maqueta de dos columnas no tiene forma de decir cuál va primero, y el espacio entre palabras suele ser un movimiento de posición y no un carácter de espacio. Las herramientas de extracción adivinan el orden a partir de la geometría, y en una maqueta compleja adivinan mal.
¿Qué metadatos contiene un PDF?
Título, autor, asunto, palabras clave, la aplicación que creó el contenido, la biblioteca que escribió el archivo y las fechas de creación y modificación con huso horario. Muchos archivos llevan una segunda copia de todo eso en un bloque XMP que puede no coincidir con la primera. Es texto libre escrito por software, así que trátalo como una afirmación y no como un hecho, y revísalo antes de mandar el archivo.
¿El texto tapado con un recuadro negro en un PDF desaparece?
No. El recuadro negro es una instrucción de dibujo pintada encima del texto, y el texto sigue abajo, en el flujo de contenido, donde cualquier herramienta de extracción lo va a encontrar. Lo mismo pasa con una página recortada: una caja de recorte más chica que la hoja oculta el contenido sin eliminarlo. Tachar de verdad es borrar los glifos del flujo.
Última actualización 21 de septiembre de 2026