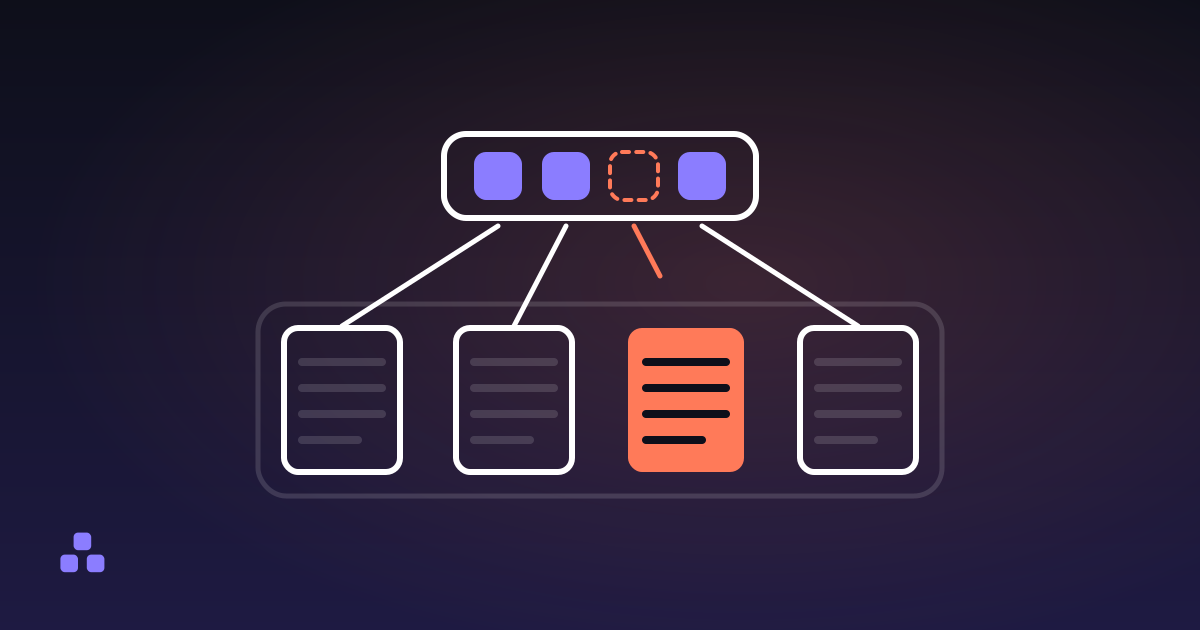
Para excluir páginas de um PDF, abra o arquivo numa ferramenta que o reescreva, indique as páginas que sobram (2, 5-7, 12-) e salve o que ficou. Essa parte leva dez segundos. A parte que ninguém menciona é que remover uma página e remover o conteúdo dela são duas operações diferentes num PDF, e uma ferramenta pode fazer a primeira sem fazer a segunda. A página some de todos os visualizadores, os bytes ficam no arquivo, e o documento que você acabou de mandar por e-mail continua carregando a página que você achava que tinha excluído.
Onde uma página fica guardada?
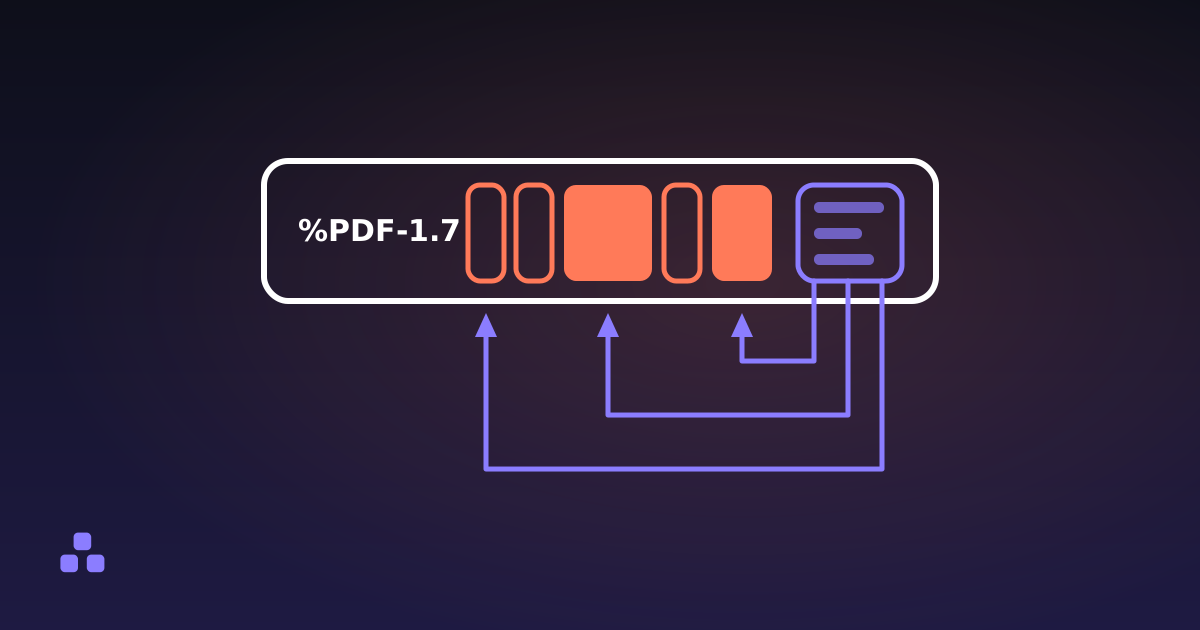
Não numa pilha. Um PDF é um monte de objetos numerados (dicionários, arrays e fluxos comprimidos de instruções de desenho) indexados por uma tabela no fim que anota em que byte cada um começa. Nada é guardado em ordem de leitura: um leitor acha a página 400 seguindo o catálogo até a árvore de páginas, percorrendo-a até a folha de número quatrocentos e pulando para o byte anotado para ela. O que existe de fato dentro de um arquivo PDF desmonta essa estrutura objeto por objeto; aqui importa um único nível.
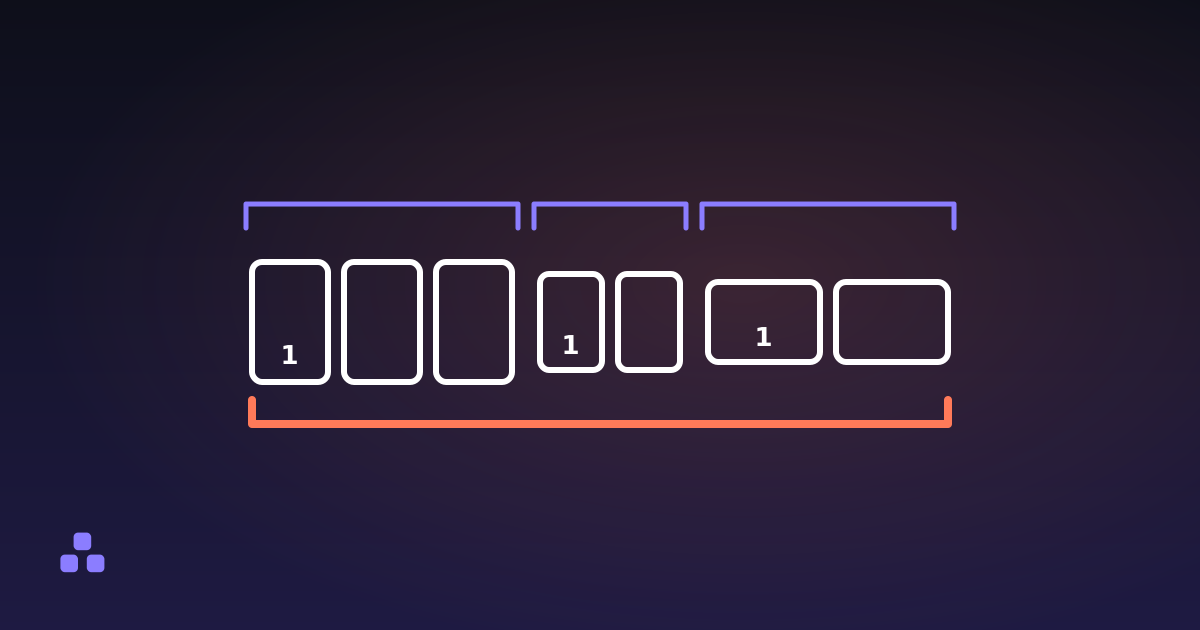
Uma página pertence ao documento porque uma lista a nomeia. A árvore de páginas é um nó com um array de filhos, e cada filho é outro nó ou um dicionário de página, que aponta para o fluxo de conteúdo que desenha a página e para as fontes e imagens de que ela precisa. Tire a página desse array, corrija a contagem do nó acima, e todo leitor do mundo mostra uma página a menos. Você não encostou no dicionário da página nem no fluxo de conteúdo dela. Você editou uma lista.
O que significa "sem referência" e por que o conteúdo sobrevive
Um objeto para o qual nada aponta continua sendo um objeto do arquivo. Ele tem seu número, tem sua entrada na tabela de referências cruzadas, e está no fluxo de bytes exatamente onde sempre esteve. Os visualizadores nunca o desenham, porque um visualizador só desenha o que a árvore de páginas alcança. Outras coisas o acham fácil: um extrator de texto que varre objetos em vez da árvore tira as palavras de lá, e um descompressor deixa tudo à vista.
Escrever só os objetos alcançáveis (uma passada de coleta de lixo) é trabalho comum para uma biblioteca de PDF, e as cuidadosas fazem. Mas é trabalho extra, dá para pular, e o arquivo que sai abre igualzinho ao arquivo que guardou tudo. Nada no formato exige essa passada, e nada no seu visualizador diz qual dos dois arquivos você tem na mão.
O outro jeito de uma página excluída ficar: o salvamento incremental
O PDF tem um segundo recurso que produz o mesmo resultado de propósito. Um arquivo pode ser atualizado por acréscimo: o editor escreve os objetos que mudaram depois dos bytes existentes, soma uma seção de referências cruzadas apontando para eles, e termina com um trailer novo. O arquivo original embaixo fica intacto. A seção nova diz que a árvore de páginas agora é este outro objeto, enquanto a árvore antiga, as páginas antigas e todos os fluxos de conteúdo que elas usavam continuam ali, nos primeiros sei lá quantos megabytes.
Isso não é um defeito: um salvamento incremental leva o mesmo tempo qualquer que seja o peso do arquivo, e uma assinatura aplicada a uma revisão anterior só sobrevive porque os bytes assinados continuam lá. O perigo está na palavra "salvar", que as pessoas leem razoavelmente como "o arquivo agora contém o que eu vejo".
Como eu confiro se a página sumiu mesmo?
Conte as marcas %%EOF. Toda seção de referências cruzadas termina em uma, e salvar em cima de um arquivo que já existe acrescenta uma seção em vez de substituí-la. Abra o PDF num editor de texto puro e procure por essa sequência. Uma marca só significa uma seção só, sem nada embaixo. Mais de uma tem duas causas, e onde está a marca a mais diz qual delas: um arquivo linearizado, feito para a exibição rápida na web, carrega uma segunda seção dentro dos primeiros kilobytes, enquanto cada salvamento posterior deixa uma marca no fim dos bytes que acrescentou. Duas marcas com a primeira perto do começo são um arquivo linearizado comum. Qualquer outra coisa significa que versões anteriores do documento continuam lá dentro.
Olhe o tamanho. Um arquivo que perdeu metade das páginas e nenhum byte está te dizendo alguma coisa. Só não leia o contrário com confiança demais: mesmo uma reescrita limpa quase nunca encolhe na mesma proporção das páginas removidas, porque a fonte embutida e o logo que aparecia em toda página estavam guardados uma única vez e ficam por causa das páginas que você manteve. Metade das páginas fora e só uma fração dos bytes fora é o comum; metade das páginas fora e nenhum byte, não é.
Descomprima e procure. O conteúdo das páginas vive em fluxos comprimidos, então procurar no arquivo cru uma frase da página excluída normalmente não acha nada, esteja a página lá ou não. O comando qpdf --qdf --preserve-unreferenced in.pdf out.pdf reescreve o documento com os fluxos expandidos e disposto para ser lido. A segunda opção é a que importa aqui: sem ela, o qpdf descarta os objetos para os quais nada aponta, que são justamente os que você veio buscar. Procure nessa cópia uma frase que você excluiu; se ela voltar, a página voltou junto. Isso acha os órfãos que o índice ainda lista. O conteúdo preso numa revisão anterior é o que a contagem de marcas pega.
O que você não pode fazer é julgar abrindo o arquivo: todos esses documentos parecem corretos num visualizador, e esse é o problema inteiro. Um leitor de estrutura responde as perguntas normais em vez disso: o inspetor de PDF daqui informa a quantidade de páginas, o tamanho e a rotação de cada uma, qual programa o escreveu e se uma página está cortada. O corte é a versão própria dessa armadilha: uma caixa de corte diz ao visualizador que parte da folha exibir e não remove nada.
Como é uma exclusão limpa
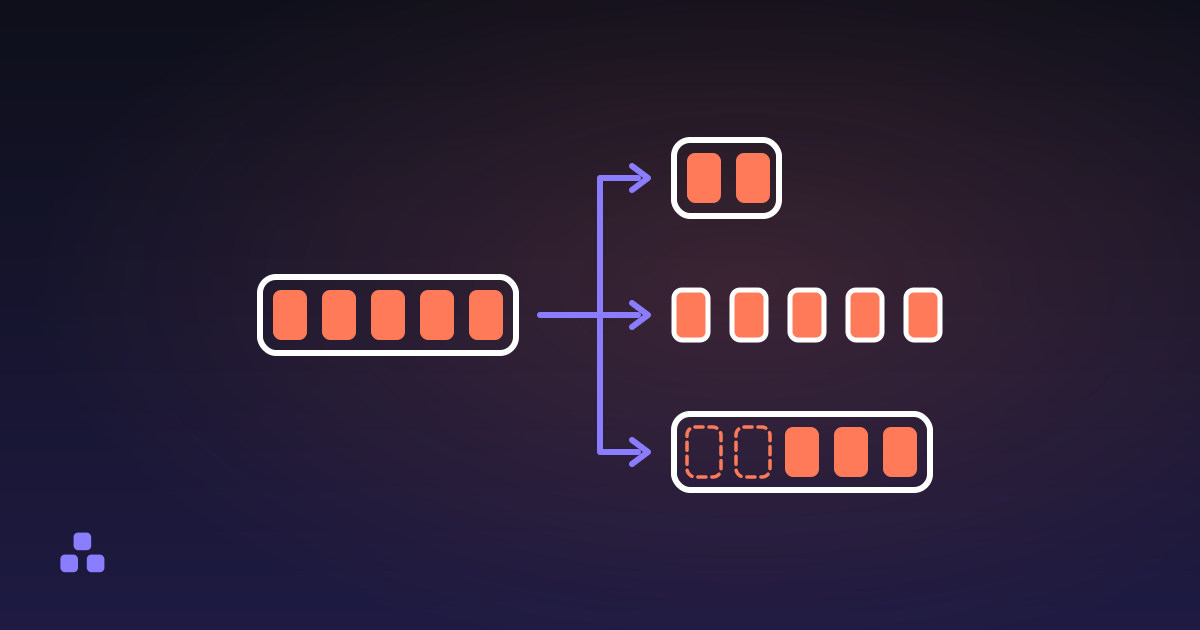
A operação segura não é "tire estas páginas" e sim "escreva um documento novo contendo só as páginas que eu mantenho". Copie cada página sobrevivente para um arquivo vazio com todo o grafo de referências dela (as fontes que usa, as imagens que desenha, as anotações de cima), renumere esses objetos, escreva uma tabela de referências cruzadas nova, e pare. As páginas excluídas não são removidas, porque nunca foram copiadas, e não existe uma revisão anterior embaixo, porque o arquivo é novo.
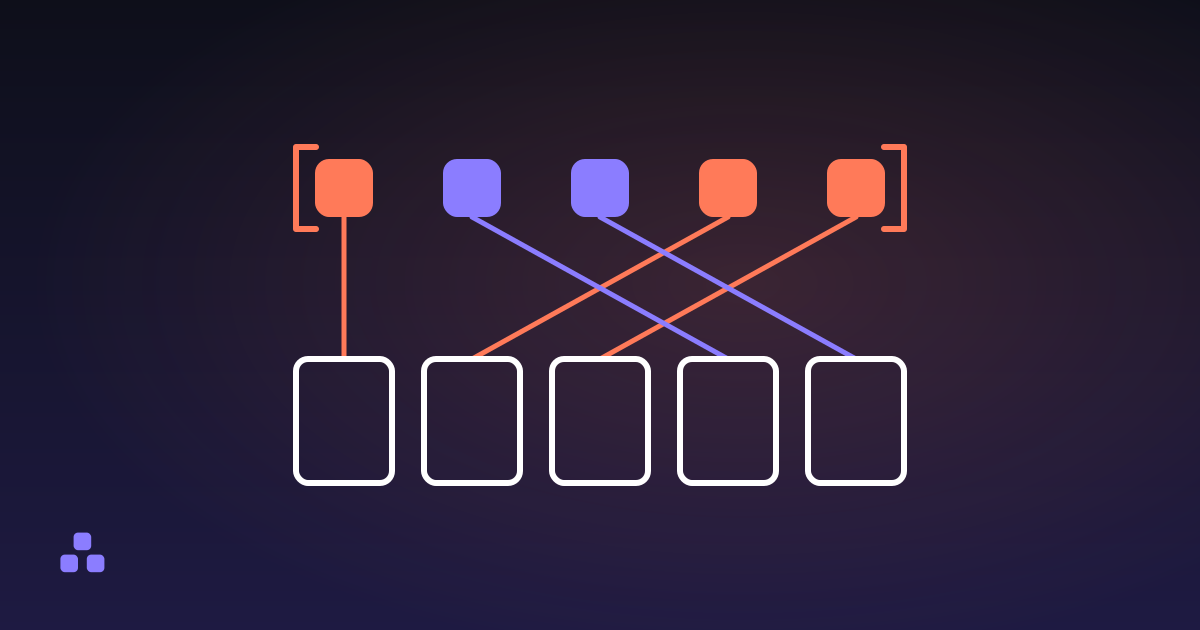
Existe um jeito de errar isso, e ele parece capricho. Uma página que você manteve pode carregar um link cujo destino é uma página que você excluiu. Um copiador que segue cada referência que encontra desce por esse link, copia o dicionário e o fluxo de conteúdo da página excluída para o arquivo novo, e deixa os dois pendurados em nada: a árvore de páginas diz que a página sumiu e os bytes dizem outra coisa. A saída é tratar uma referência a uma página como uma reserva: separar um número de objeto, preencher esse número só se a página for adicionada, e descartar o link se ela nunca for.
É assim que funciona o removedor de páginas deste site: você digita as páginas ou clica nelas numa fila numerada, e ele monta a saída a partir das sobreviventes. Não há miniaturas, porque desenhá-las significa mandar um motor de renderização para cada pessoa que abre a página, então ele informa a quantidade de páginas e o tamanho e a rotação de cada uma. Roda inteiramente no seu navegador, então o documento que você ia mandar por e-mail também não é enviado para lugar nenhum, e as páginas que você mantém são copiadas byte a byte com a compressão que já tinham.
O que a reescrita custa a você
Construir um arquivo novo é a troca certa, mas é uma troca. O que vive no nível do documento e não em cima de uma página não sobrevive:
- Marcadores e rótulos de página. O sumário lateral some, e um arquivo numerado i, ii, 1, 2 volta numerado 1, 2, 3, 4.
- O comportamento dos formulários. Os campos continuam desenhados, porque os widgets deles ficam sobre as páginas, mas o dicionário de formulário do documento é descartado e eles chegam inertes.
- As assinaturas digitais. Uma assinatura cobre uma sequência específica de bytes, então qualquer reescrita a invalida. Não há o que fazer além de assinar de novo depois.
- Os links escritos como nome. Um link que aponta para um nome se resolve por uma tabela do catálogo, e um arquivo novo não herda essa tabela. Um que aponta direto para um objeto de página funciona nos dois sentidos, desde que a página que ele cita tenha sobrevivido; um link para uma página excluída é descartado junto com ela.
Os números impressos nas páginas também não mudam. O "23" de um rodapé é texto desenhado dentro do fluxo de conteúdo daquela página, e nada no arquivo sabe que aquilo é um número: renumerar significaria diagramar a página de novo. E se você quer guardar essas páginas em vez de jogá-las fora, a operação é outra: dividir um PDF em arquivos separados mantém tudo e apenas distribui.
Excluir uma página não é tarjar informação
Tudo o que veio acima trata de uma página que você quer fora por completo. Se o que é sensível é um nome ou um parágrafo numa página que você vai manter, excluir páginas não resolve nada. Os dois truques que as pessoas usam no lugar disso também não. Um retângulo preto desenhado sobre um texto é um retângulo desenhado sobre um texto: os caracteres continuam embaixo, no fluxo de conteúdo, e selecionar aquela área os copia. Cortar é pior, porque parece permanente enquanto não remove nada. Tarjar de verdade apaga os caracteres do próprio fluxo, outro trabalho que vale fazer com software dedicado.
Se você tem um arquivo para resolver e não um mecanismo para entender, o removedor de páginas de PDF pega os números ou os cliques, monta um documento novo com as páginas que você mantém e baixa esse documento sem que o arquivo saia da sua máquina. Ele não abre PDFs protegidos por senha e perde os marcadores, então confira o resultado quando a estrutura do documento importar tanto quanto a lista de páginas.
E se o que ficou martelando foi a estrutura (os objetos, a tabela de referências cruzadas, por que uma página é uma entrada de lista e não uma página) o que existe de fato dentro de um arquivo PDF é a versão longa. Ele explica quase todas as outras surpresas do formato também, inclusive por que um PDF que parece bom pode estar tecnicamente quebrado e abrir em todo lugar do mesmo jeito.
Perguntas frequentes
Excluir uma página de um PDF remove mesmo o conteúdo dela?
Nem sempre. Uma página pode sair da árvore de páginas enquanto o dicionário e o fluxo de conteúdo dela ficam no arquivo como objetos sem referência, que nenhum visualizador desenha mas qualquer extrator de texto encontra. Depende inteiramente de a ferramenta reescrever o documento ou apenas editar a lista de páginas. Uma ferramenta que constrói um arquivo novo com as páginas que você mantém é a do tipo seguro, desde que ela não siga um link de uma página mantida para uma excluída e copie essa página junto.
Como eu sei se uma página excluída continua dentro do PDF?
Abra o arquivo num editor de texto puro e conte as marcas %%EOF. Uma só significa uma passada só, sem nada embaixo; uma segunda dentro dos primeiros kilobytes é a linearização comum, e qualquer marca mais adiante é uma revisão anterior que continua ali. Para uma resposta definitiva, rode qpdf --qdf --preserve-unreferenced nele para expandir os fluxos e manter os objetos para os quais nada aponta, e depois procure no resultado uma frase da página que você excluiu. Se o texto estiver lá, a página também está.
Por que meu PDF tem o mesmo tamanho depois de excluir páginas?
Ou as páginas saíram da lista sem sair do arquivo, ou o editor acrescentou a mudança no fim em vez de reescrever o documento. Encolher menos do que a proporção de páginas excluídas é normal, porque fontes e logos compartilhados entre páginas são guardados uma vez só e ficam. Não encolher nada é um sinal de alerta que vale conferir.
Como excluo páginas de um PDF de graça sem instalar nada?
Use uma ferramenta de navegador que processe o arquivo localmente, como o removedor de páginas deste site: solte o PDF, digite as páginas a excluir como números soltos ou intervalos, e baixe o que sobrou. Nada é enviado e não é preciso ter conta. A exceção são os arquivos protegidos por senha: esses precisam ser desbloqueados antes, no programa que os protegeu.
Excluir uma página é a mesma coisa que tarjar informação?
Não. Excluir tira uma página inteira, e só de verdade se a ferramenta reescrever o arquivo. Tarjar remove conteúdo pontual de uma página que você vai manter, o que exige editar o próprio fluxo de conteúdo. Desenhar uma caixa preta sobre um texto ou cortar a página esconde aquilo na tela e deixa cada caractere no lugar.
Os números de página impressos no documento se atualizam depois que eu excluo uma página?
Não. Os números de página em cabeçalhos e rodapés são texto desenhado dentro do fluxo de conteúdo de cada página, e nada no arquivo os marca como números de página. Depois de excluir a página 5, todos os rodapés seguintes ficam deslocados em um, e um sumário continua apontando para a numeração antiga. Exportar de novo do programa que criou o documento é a única correção real.
Última atualização 21 de setembro de 2026