Existem dois caminhos e eles não produzem o mesmo arquivo. Dentro do Word: Arquivo → Salvar como e escolher PDF na lista de tipos. Fora do Word: entregar o .docx a um conversor e ficar com o que ele devolve. Nos dois casos são poucos segundos. Só que toda conversão de Word para PDF é uma troca, e o que você troca depende de uma pergunta: o conversor tem as suas fontes? Se tiver, você recebe uma cópia. Se não tiver, você recebe as mesmas palavras recompostas com outras letras, com as quebras de linha e a contagem de páginas em outros lugares.
O que é de verdade um .docx
Um arquivo do Word é um zip usando outra extensão. Renomeie um para .zip, abra, e dentro há uma pasta de XML: word/document.xml tem o texto e sua estrutura, word/styles.xml os estilos nomeados, word/media/ as imagens. O formato é publicado, e um editor de texto puro consegue ler. Nada disso é segredo.
O importante é o que não está lá dentro: páginas. Um .docx não tem página 1 nem página 7. Ele guarda parágrafos, estilos e um tamanho de página, e a paginação é recalculada toda vez que alguma coisa abre o arquivo. É por isso que o mesmo documento repagina quando você o abre em outro computador ou troca de driver de impressora, e por isso a conversão é o momento em que as páginas são finalmente decididas. Um PDF não é outra coisa senão páginas.
Por que a conversão pode acontecer na sua própria máquina
Porque um navegador já faz as duas metades do trabalho: descompacta arquivos e lê XML, e um PDF é um formato baseado em texto que dá para escrever com operações de strings. Nada disso precisa de servidor, e aqui isso importa mais do que na maioria dos casos: um documento do Word costuma ser um contrato, um currículo ou um exame médico, e o conversor gratuito de sempre pede que você entregue justamente isso a uma máquina sobre a qual você não sabe nada. O conversor de Word para PDF daqui descompacta e lê o arquivo dentro da aba e escreve o PDF ali também, então você pode se desconectar da internet depois que a página carregar e ele continua funcionando.
Por que o PDF não fica igual ao meu documento do Word?
As fontes. Quase sempre, só as fontes.
Um PDF pode nomear uma fonte de duas formas. Ele pode incorporá-la, ou seja, copiar o próprio programa da fonte — normalmente só os glifos que o documento usa — de modo que o texto seja desenhado igual numa máquina que nunca ouviu falar daquela tipografia. Ou pode apontar para uma das catorze fontes padrão que todo leitor de PDF traz desde 1993: Helvetica, Times e Courier em quatro estilos cada, mais Symbol e ZapfDingbats. Nomear uma dessas não custa nada.
A fonte padrão do Word não é nenhuma delas. A Calibri foi a padrão por anos e a Aptos é a padrão agora, e nenhuma das duas é uma fonte padrão de PDF, então um PDF que queira parecer o seu documento precisa levar a tipografia junto. A exportação do próprio Word faz isso, porque a fonte está instalada na máquina que exporta. Um conversor que não tem a sua fonte não consegue inventá-la.
O pior resultado é um PDF que nomeia uma fonte que nunca incorporou: o leitor substitui por algo com proporções mais ou menos parecidas, então o arquivo fica diferente em cada máquina que o abre, que é exatamente o que o formato existe para evitar. Melhor dizer na cara: o conversor deste site compõe o seu texto em Helvetica — e em Courier o que estava em monoespaçada — e diz isso, em vez de nomear uma fonte que não tem. Suas palavras saem exatamente como as suas palavras; as formas não são as suas.
O que de fato se move quando as fontes são trocadas
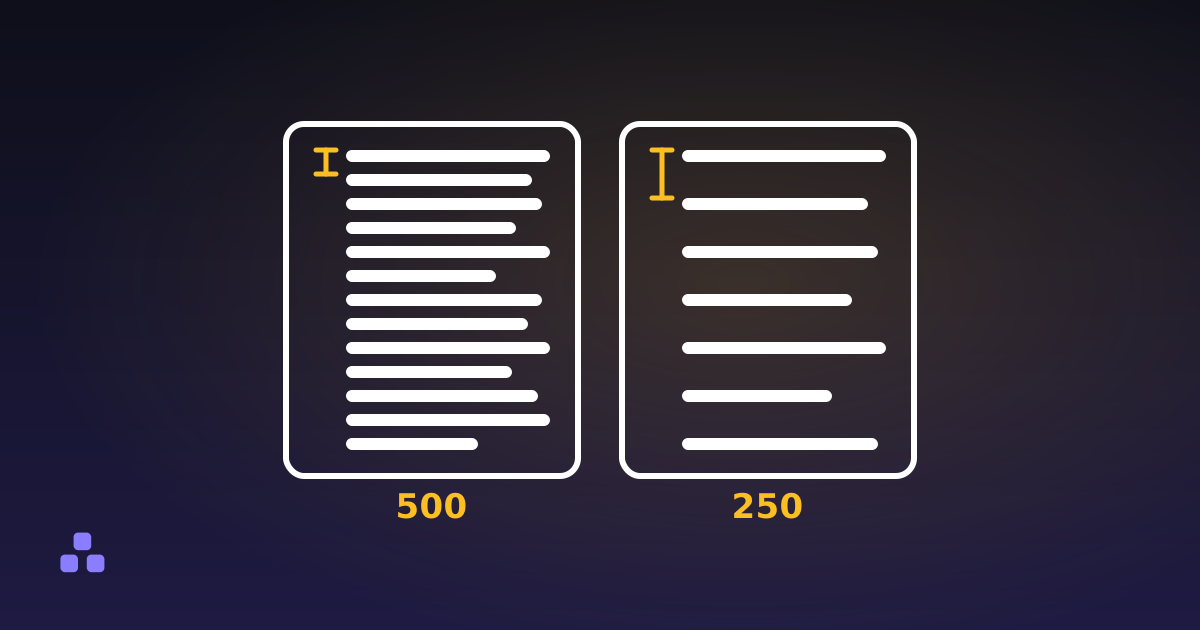
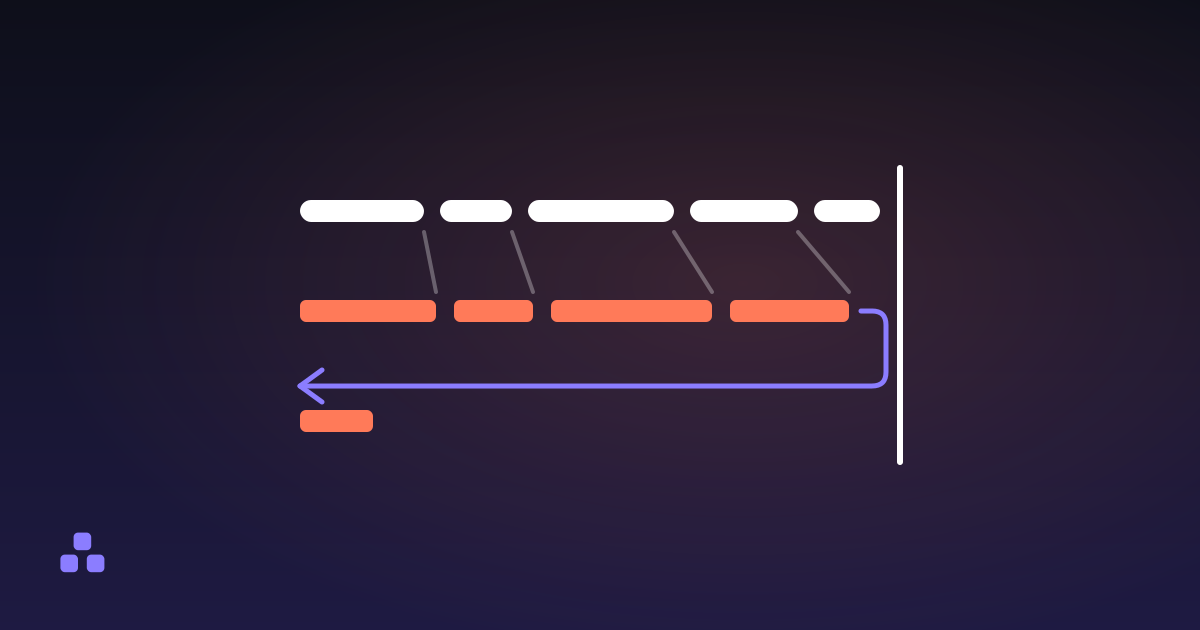
Cada caractere tem uma largura, e trocar a tipografia muda todas de uma vez. O texto se reorganiza, e o estrago cai em lugares previsíveis:
- As quebras de linha. Uma linha que no Word terminava em "no entanto" agora termina uma ou duas palavras antes, ou depois.
- A contagem de páginas. Quatro páginas caprichadas viram quatro e três linhas. Títulos escorregam para o pé da página e parágrafos se partem na virada. Quantas palavras cabem em uma página é a aritmética por baixo disso, e explica por que uma tipografia mais estreita recupera uma página.
- As tabelas. O texto das células se reorganiza como qualquer outro texto, então uma linha que tinha a altura de uma linha passa a ter duas e a tabela cresce para baixo.
- Tudo que foi alinhado com espaços ou tabulações. Linhas de assinatura, colunas improvisadas, cabeçalhos espaçados na mão: sempre frágeis, e uma troca de fonte é o que termina de quebrá-los.
Existe uma única saída estreita. Algumas fontes são compatíveis em métricas com outras: larguras idênticas por caractere, desenhos diferentes. A Arial foi construída com as larguras da Helvetica, e a Carlito e a Caladea, que vêm com o LibreOffice, batem com a Calibri e a Cambria. Uma substituição dentro de um desses pares deixa as quebras de linha onde estavam. Calibri para Helvetica não é um desses pares, então aqui a reorganização é inevitável.
Quando a exportação do próprio Word é a resposta certa?
Sempre que o layout for o conteúdo. Um currículo em que o espaçamento é o design, um folheto, um formulário que alguém preenche à mão, um relatório com um índice que cita números de página: aí uma quebra de página no lugar errado é um defeito, não uma diferença cosmética. Word, LibreOffice e Google Docs têm as suas fontes e as próprias regras de layout, então exportar pelo programa que fez o arquivo devolve uma foto do que você estava vendo.
É também a resposta sempre que o documento tem imagens: posicionar uma imagem como o Word posicionou significa reproduzir as regras de ancoragem e de ajuste de texto dele, e mais ou menos certo é pior do que honestamente ausente. E se o arquivo precisa atender a um padrão de arquivamento como o PDF/A, as fontes incorporadas são uma exigência do formato, não uma preferência.
Quando um conversor no navegador é a troca melhor?
Quando você quer o conteúdo fixo e legível em vez de idêntico pixel a pixel, e prefere não fazer upload de nada. Uma cópia para leitura, um rascunho para comentar, um anexo para alguém sem Word. Você abre mão da tipografia exata e da paginação exata. Ganha privacidade, velocidade e um arquivo bem menor: um PDF sem fontes incorporadas e sem histórico de revisões costuma pesar uma fração do .docx de onde veio.
Tenha clareza sobre o que mais fica para trás, porque é aqui que os conversores ficam calados. As imagens são descartadas. Cabeçalhos, rodapés e notas de rodapé são descartados. Um layout de várias colunas não é descartado e sim achatado: o texto sobrevive, em uma coluna só. O controle de alterações se resolve no texto inserido e as exclusões ficam de fora. O tamanho de página original também não é lido do documento, então você mesmo escolhe A4 ou Carta. A largura das suas colunas também não é lida: todas as colunas saem com a mesma largura, e uma tabela sem bordas chega com traços visíveis. A ferramenta avisa sobre as imagens, as colunas, os cabeçalhos e rodapés, as notas de rodapé e o controle de alterações antes da conversão, que é o único momento útil para você saber. Ela não diz nada sobre as colunas das tabelas nem sobre os hiperlinks, que mantêm o texto e perdem o endereço. E quando o resultado precisa viajar com outros documentos, juntá-los em um único PDF é outro trabalho que também não precisa de upload.
Por que o caminho inverso, de PDF para Word, é o difícil?
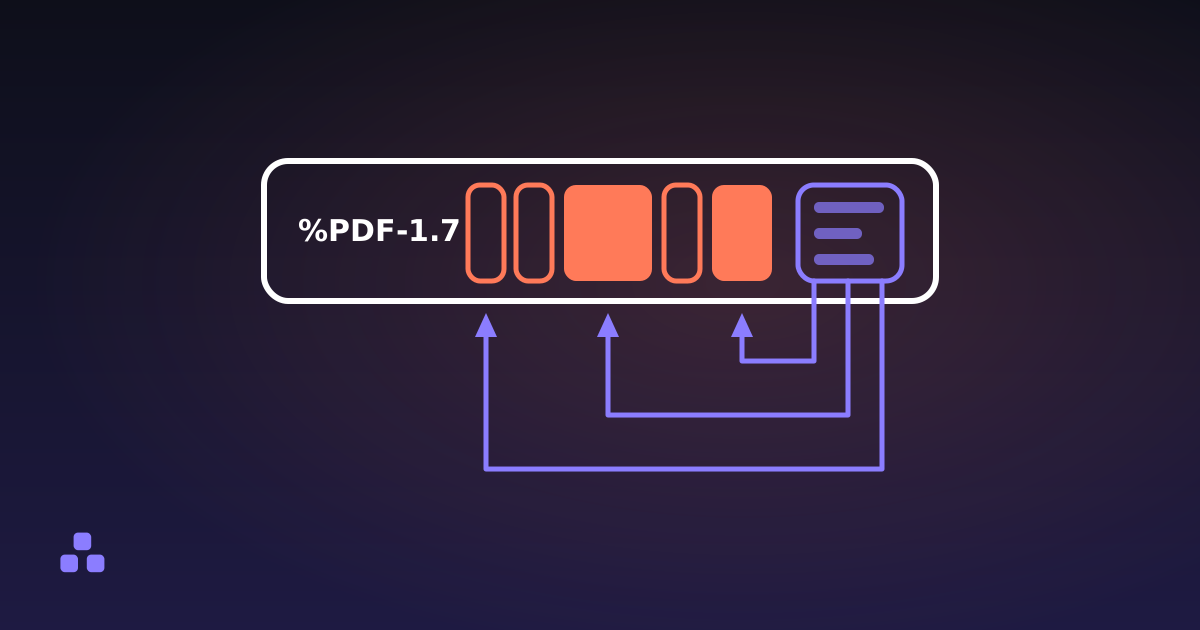
Porque um PDF não contém parágrafos. Ele contém instruções para desenhar o glifo número 47 em um par de coordenadas, numa fonte, num corpo. O que você lê é um desenho que por acaso é feito de letras.
Recuperar "isto é um título, esta palavra está em negrito, estas linhas são um parágrafo" exige ler as fontes incorporadas, mapear seus números internos de glifo de volta para caracteres através de uma tabela que o formato não obriga a incluir, e depois inferir a estrutura a partir das posições. Quando essa tabela falta, o texto não pode ser recuperado sem adivinhação, e um conversor que erra a adivinhação de vez em quando é pior do que nenhum, porque você descobre qual vez foi depois de mandar o arquivo. O que existe de verdade dentro de um arquivo PDF desmonta o formato direito, e mostra por que o caminho de ida é muito mais fácil.
O que conferir antes de enviar
- A contagem de páginas, contra o original. Se mudou, tudo o que estava abaixo da mudança se moveu junto.
- A primeira e a última página, atrás de um título abandonado no pé ou de uma linha solta de parágrafo no topo.
- As tabelas, atrás de linhas que cresceram e células que agora quebram em duas linhas.
- Os caracteres de fora da Europa ocidental. As fontes padrão trazem o Latin-1 e a pontuação tipográfica de sempre, então os acentos, o ç, as aspas curvas, o travessão e o sinal de euro passam todos. Grego, cirílico e chinês não, e nem um ł polonês, um ğ turco ou uma seta. Cada um sai como ponto de interrogação, e o conversor diz quantos foram.
Nada disso leva mais tempo do que abrir o arquivo e rolar até o fim. Fazer isso uma vez sai mais barato do que descobrir pelo destinatário que a página seis está em branco.
Se o seu documento é texto — um relatório, uma carta, um rascunho, uma cópia de currículo para leitura — o conversor de Word para PDF faz tudo dentro da aba e avisa de saída o que o seu arquivo tem que não vai sobreviver à viagem. Se o layout é o ponto, exporte pelo Word: é a troca inteira em uma frase só.
Depois que o PDF existe, ele quase sempre tem para onde ir. Como juntar PDFs sem fazer upload cobre o passo que a maioria precisa em seguida: costurar o arquivo convertido com as digitalizações e anexos com que ele precisa viajar, na ordem certa, sem entregar o conjunto a um servidor.
Perguntas frequentes
Como eu converto um documento do Word em PDF de graça?
O próprio Word faz isso com Arquivo → Salvar como e PDF como tipo de arquivo, e o LibreOffice e o Google Docs também, sem pagar nada. Um conversor no navegador faz sem nem abrir o Word, o que ajuda numa máquina que não o tem instalado. A diferença não é preço e sim fidelidade: os programas que têm as suas fontes conseguem incorporá-las, e um conversor que não as tem é obrigado a substituir.
Por que meu PDF fica diferente do meu documento do Word?
Porque as fontes mudaram. Um PDF incorpora as tipografias que usa ou se apoia nas catorze padrão que todo leitor fornece, e Calibri e Aptos não estão entre essas catorze. Quando o conversor não tem uma cópia da sua fonte, o texto é composto com outra, e como as larguras das letras diferem, as linhas e as páginas quebram em lugares novos.
Os números de página continuam os mesmos depois de converter para PDF?
Só se as fontes continuarem as mesmas. Um .docx não guarda páginas: a paginação é recalculada toda vez que o documento é diagramado, então uma substituição de fonte pode acrescentar ou tirar uma página. Se um índice de páginas ou uma citação depende disso, exporte pelo Word, que tem as fontes e o próprio motor de layout.
É seguro converter Word em PDF online?
Depende inteiramente de o site enviar ou não o seu arquivo. A maioria envia, o que significa que seu contrato ou currículo fica num servidor sob uma política de retenção que você nunca leu. Um conversor que roda no navegador nunca transmite o documento, então nada sai do seu computador e não há conta nenhuma para criar.
Dá para converter um PDF de volta em documento do Word?
Não de forma confiável, e isso é uma propriedade do formato, não um recurso que falta. Um PDF guarda posições de glifos em vez de parágrafos, e transformar isso de volta em texto depende de uma tabela de mapeamento que o arquivo não é obrigado a incluir. Quando a tabela não está lá, os caracteres originais não podem ser recuperados sem adivinhação, e por isso esse caminho não é oferecido neste site.
Dá para converter um arquivo .doc antigo em PDF?
Não diretamente. O formato binário .doc do Word 2003 e anteriores é uma coisa completamente diferente do .docx, que é um zip de XML. Abra no Word ou no LibreOffice, salve primeiro como .docx, e então converta esse arquivo.
Última atualização 21 de setembro de 2026