Converter imagens em PDF é colocá-las na ordem que você quer, escolher se cada página vai ter o tamanho da sua imagem ou vai ser uma folha A4 fixa, e montar o arquivo. O que isso custa depende inteiramente do conversor: quase todos decodificam suas fotos e comprimem tudo de novo no caminho, e nenhum precisa fazer isso. Um PDF pode carregar os dados comprimidos de um JPEG byte a byte, exatamente como eles saíram da câmera.
Por que a maioria dos conversores piora suas fotos
O jeito fácil de construir uma ferramenta dessas é decodificar cada imagem em pixels, desenhá-la num canvas e codificar um JPEG novo com o que sobrou ali. Um único caminho de código atende todo formato de entrada, e é por isso que tanto software funciona assim.
Isso também joga detalhe fora sem ganhar nada. JPEG tem perdas: ao codificar ele descarta o que julga que você não vai sentir falta, e julga sobre a imagem que tem na frente. Passe uma foto já comprimida por uma segunda codificação e essa passada gasta o orçamento dela nos artefatos da primeira. As bordas ganham um halo fraco, o céu plano se quebra em blocos maiores, e o arquivo não fica menor de forma confiável: uma recodificação com uma qualidade mais alta que a do original sai maior.
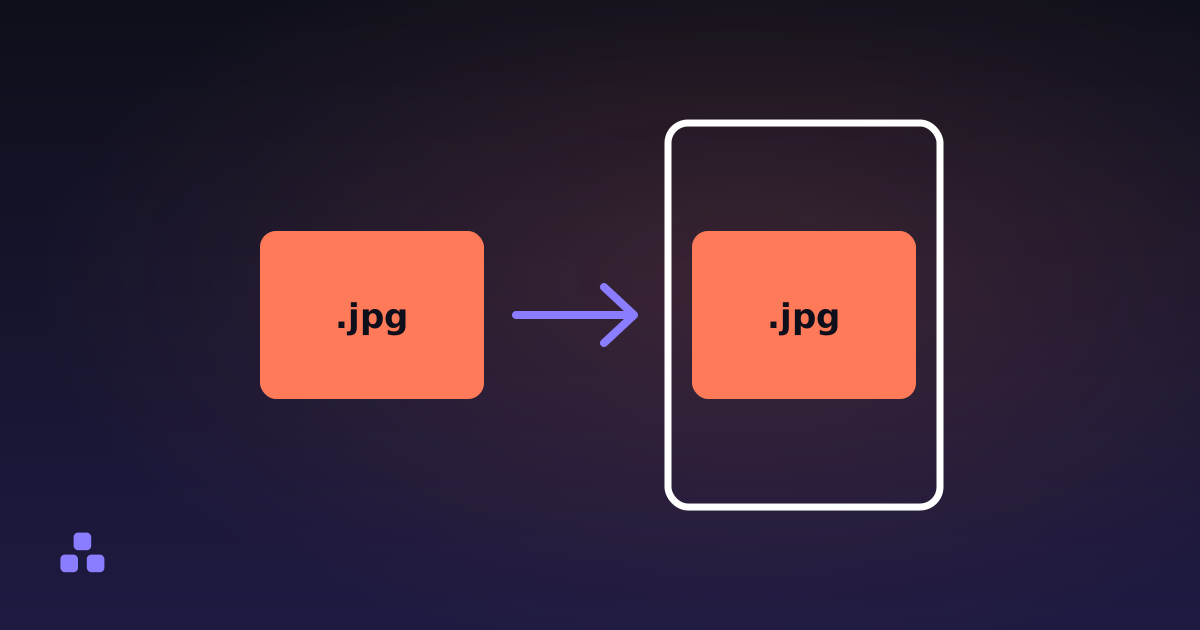
A solução não é um ajuste de qualidade melhor. É não recodificar. A ferramenta de imagens para PDF daqui copia os dados comprimidos do JPEG direto para o documento e marca cada arquivo que tratou assim, para você ver quais imagens entraram intactas e quais precisaram ser refeitas.
Como um PDF guarda um JPEG sem recodificar?
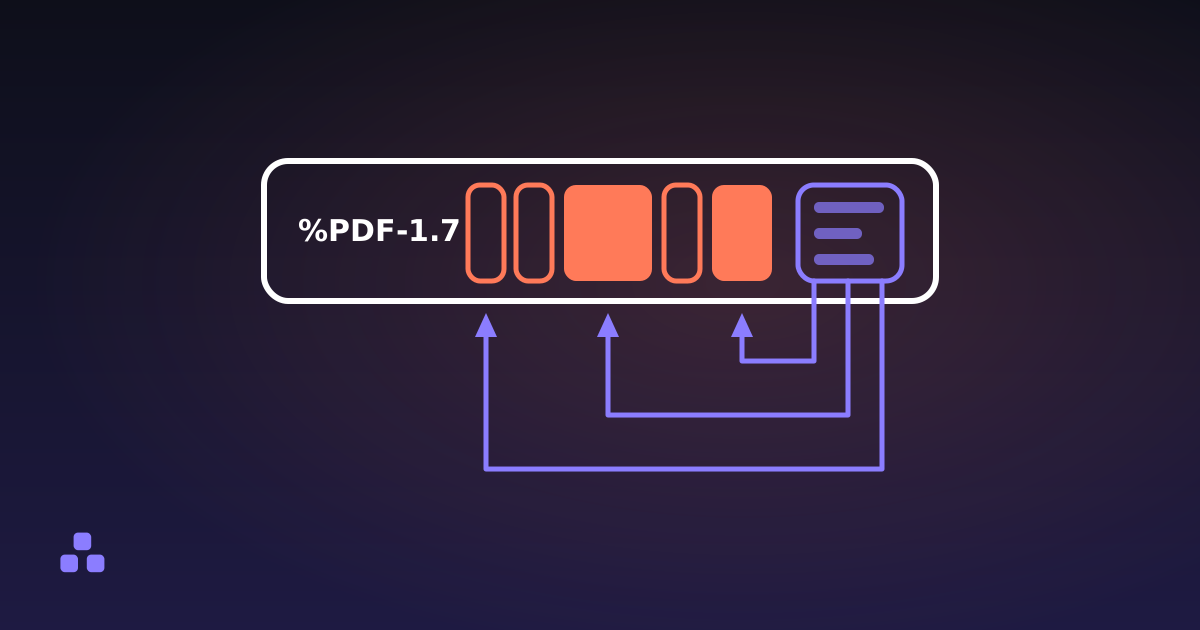
Uma imagem dentro de um PDF não faz parte da página. Ela é um objeto separado, um XObject, ao qual a página se refere pelo nome. A página carrega um MediaBox — quatro números que dão os cantos da folha em pontos — e um content stream, um programa bem curto dizendo desenhe a imagem Im0, aqui, deste tamanho. Seis números, uma matriz, e o desenho está pronto. O que existe de verdade dentro de um arquivo PDF desmonta o resto disso.
Todo objeto de imagem declara um filtro dizendo como os bytes dele estão comprimidos, e um desses filtros é o DCTDecode. DCTDecode é JPEG, e o nome vem da transformada discreta de cosseno sobre a qual o JPEG é construído. Os dados comprimidos dentro de um arquivo .jpg são exatamente o que um XObject de imagem espera: as tabelas e o scan em si passam do jeito que estão, e só os blocos de metadados em volta deles são descartados. Não muda nem um coeficiente, e o próprio decodificador JPEG do visualizador faz o trabalho.
Quais JPEGs conseguem entrar intactos?
Quase todos, não todos. Passam do jeito que estão: JPEG baseline, sequencial estendido e progressivo a oito bits por amostra, em tons de cinza ou em cores. Isso é toda foto que um celular ou uma câmera comum faz. Não passam: as amostras de doze bits, a codificação aritmética e os CMYK de quatro canais de um fluxo de gráfica. Um JPEG CMYK até cabe dentro de um PDF, mas os quatro canais dele costumam estar gravados invertidos e o arquivo nem sempre avisa. Se isso for lido errado, a foto chega como o próprio negativo dela, então esses são decodificados e refeitos em RGB. O mesmo vale para qualquer JPEG cujos marcadores param de fazer sentido antes de os dados da imagem começarem. Uma imagem que o navegador não consegue decodificar fica de fora com o nome dela, e as outras páginas são montadas do mesmo jeito.
Por que um PNG não recebe o mesmo tratamento?
Não existe filtro PNG em PDF. O mais próximo é o Flate, a mesma compressão deflate sobre a qual o PNG é construído, e dá para pedir à versão do PDF que desfaça a previsão de linhas do PNG: o truque em que cada linha é guardada como a diferença dela para os pixels ao lado e acima, que é boa parte do motivo pelo qual o PNG vai tão bem com cor chapada e bordas nítidas. Ou seja, um PNG simples e opaco poderia, em princípio, ser entregue quase como um JPEG é. Duas coisas quebram isso: um PNG entrelaçado guarda as linhas embaralhadas em sete passadas, e um com transparência intercala o alfa com a cor, enquanto o PDF quer o alfa como uma imagem separada em tons de cinza.
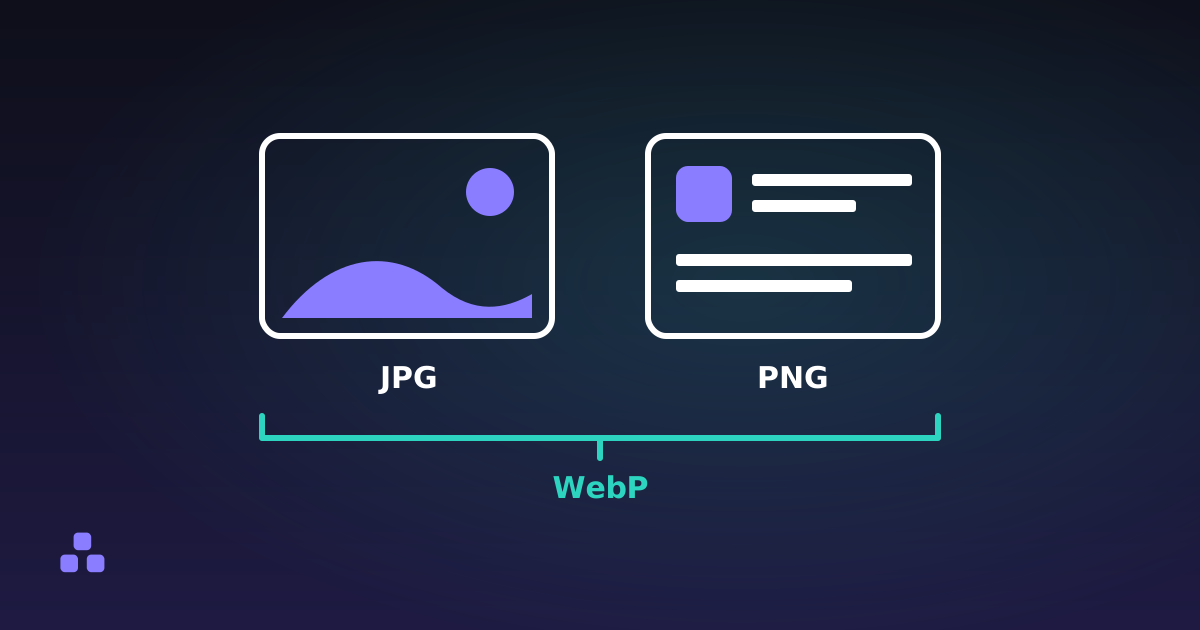
Esta ferramenta não tenta esse atalho. Um PNG é decodificado primeiro e depois guardado de uma de duas formas honestas. Guardar os valores RGB exatos e passar deflate neles, o que não perde nada e muitas vezes termina maior que o próprio PNG, porque o passo de previsão não existe mais. Ou recodificar como JPEG, bem menor e com perdas, justamente no tipo de imagem que denuncia isso: texto e desenho de linha são onde os artefatos de JPEG mais aparecem. A transparência segue o caminho escolhido — o sem perdas a mantém como uma máscara suave com o canal alfa, o de JPEG a achata sobre branco. O WebP está na mesma posição.
Se seus arquivos são na verdade fotografias que foram parar em PNGs, o conserto está antes: PNG vs JPG vs WebP explica em que formato cada tipo de imagem deve ficar. Uma foto salva como PNG é uma forma comum de terminar com um PDF várias vezes maior do que precisava ser.
O que o tamanho de página e as margens fazem de verdade?
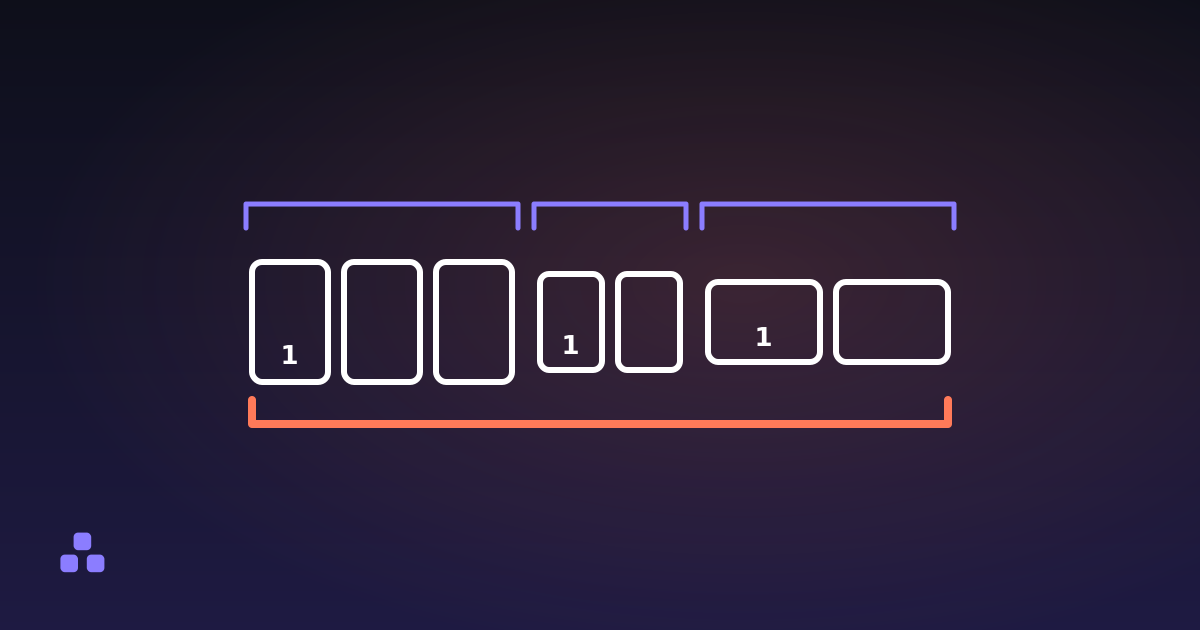
Ajustar à imagem faz cada página ficar exatamente do tamanho da sua imagem, um pixel por ponto. Nada é escalado e não sobram bordas, que é o que você quer numa tela. Uma captura de 1600 pixels de largura vira uma página de cerca de 22 polegadas, o que soa alarmante e quase nunca importa: um visualizador ajusta a página à janela e uma impressora ajusta ao papel.
Um tamanho fixo, A4 ou US Letter, é para um arquivo que vai para uma impressora ou para uma pilha de outros documentos. É aí que a proporção começa a importar. A4 é mais ou menos 1:1,41, uma foto de celular é 3:4, uma captura tem o formato do seu monitor. A imagem é escalada até caber, para cima ou para baixo, e centralizada, então o espaço que sobra aparece como barras brancas: nas laterais quando a imagem é proporcionalmente mais larga que a página, e em cima e embaixo quando é mais alta. Nada é cortado nem esticado.
As margens saem dessa caixa antes do redimensionamento, então cada milímetro é uma imagem um pouco menor; 10 mm é mais ou menos o mais perto da borda que uma impressora doméstica alcança. No modo ajustar à imagem a margem aumenta a página. O que nada disso define é um DPI: os pixels são guardados uma vez só e a página apenas registra de que tamanho desenhá-los. Uma imagem de 600 pixels esticada por um A4 imprime a uns 72 pontos por polegada e dá para notar.
O que define o tamanho de um PDF feito de imagens?
Quase inteiramente as imagens. Os objetos de página, os content streams e a tabela de referência cruzada somam algumas centenas de bytes por página. Se o documento tem 40 MB, você colocou 40 MB de dados de imagem nele, e nenhum ajuste do PDF vai mudar isso.
A alavanca está antes disso, nas imagens, antes de elas virarem páginas. Trinta fotos de celular de 4000 pixels fazem um PDF enorme, tendo sido recodificadas ou não, e se o arquivo precisa ir por e-mail, redimensionar e comprimir as imagens primeiro resolve muito mais do que o passo de conversão. Comprimir uma vez, de propósito, numa qualidade que você escolheu ganha de um conversor fazendo isso em silêncio numa que você não escolheu.
Por que as fotos do celular saem deitadas?
Porque um celular guarda a foto do jeito que o sensor viu e acrescenta uma pequena tag EXIF dizendo para que lado girar. Seu aplicativo de galeria lê essa tag; o PDF não tem equivalente, então um conversor que copia os bytes sem ler a tag enche o documento de fotos deitadas. É por isso que tantas ferramentas recodificam tudo. Existe uma resposta melhor: a rotação é uma matriz, a colocação é uma matriz, e multiplicar as duas dá uma que faz as duas coisas.
O resto do bloco EXIF não viaja. Os dados da imagem são copiados byte a byte, mas os metadados em volta deles — coordenadas de GPS, número de série da câmera, a miniatura embutida — são descartados no caminho, porque nenhum visualizador de PDF mostraria isso e você provavelmente não queria mandar junto. O que o EXIF de uma foto revela vale a leitura antes de você compartilhar imagens em algum lugar que deixe esses dados intactos.
O que um PDF feito de imagens nunca vai ser
Ele contém fotos de páginas, não páginas de texto, e daí saem três limites.
- Nada dentro dele é pesquisável. Nenhuma palavra pode ser selecionada, pesquisada ou copiada. Para o texto ser texto de verdade é preciso OCR, que precisa de um modelo treinado rodando num servidor ou baixado por inteiro. Se você vai precisar procurar palavras nessas digitalizações depois, digitalize direto para PDF com um software que rode OCR.
- Quais formatos abrem depende do seu navegador. O Safari lê HEIC; Chrome e Firefox em geral não, e nada lê RAW de câmera. Um conversor que roda na sua própria máquina só consegue usar os decodificadores que essa máquina já tem.
- Perfis de cor embutidos são descartados. Uma imagem em Display P3 volta a ser lida como sRGB: aparece nas cores saturadas, é invisível em quase todo o resto, e acontece pelos dois caminhos.
Se você tem imagens para transformar em documento agora mesmo, o conversor de imagens para PDF faz tudo o que está acima dentro do seu navegador: os JPEGs são copiados intactos, a rotação EXIF entra na matriz da página, e uma linha por arquivo diz quais passaram do jeito que estavam. Nada é enviado, então as fotos nunca saem do seu computador.
O passo seguinte costuma ser juntar o resultado a outra coisa, e como juntar PDFs sem fazer upload é o mesmo argumento em outro lugar: combinar documentos é outra operação que dá para fazer sem reescrever o que já está dentro deles.
Perguntas frequentes
Como eu converto imagens em PDF?
Coloque as imagens na ordem que você quer, escolha se cada página vai ter o tamanho da sua imagem ou vai ser uma folha fixa A4 ou US Letter, e monte o arquivo. Uma imagem vira uma página. A única decisão que afeta a qualidade é se o conversor recodifica suas fotos ou as copia do jeito que estão.
Converter uma imagem em PDF reduz a qualidade?
Não precisa reduzir. Um JPEG pode ser copiado para dentro de um PDF sem nunca ser decodificado, o que deixa a imagem idêntica bit a bit ao arquivo do qual você partiu. Um PNG ou um WebP é decodificado primeiro e depois guardado como pixels exatos, o que não perde nada mas dá um arquivo maior, ou recodificado como JPEG, que é menor e com perdas.
Por que meu PDF ficou maior que as imagens que eu coloquei nele?
Normalmente porque essas imagens eram PNG ou WebP. Guardá-las sem perder pixels significa passar deflate nas amostras cruas, e deflate sozinho comprime pior que PNG, que antes guarda cada linha como a diferença dela para os pixels ao lado e acima. Recodificá-las como JPEG deixa o arquivo bem menor ao custo de alguma qualidade.
Devo escolher A4 ou ajustar à imagem no tamanho de página?
Escolha ajustar à imagem quando o arquivo é para ler numa tela e você não quer bordas, já que aí cada página combina exatamente com a sua imagem. Escolha A4 ou US Letter quando o arquivo vai para uma impressora ou para uma pilha de outros documentos e toda folha precisa ter o mesmo tamanho físico. Margens só fazem sentido com um tamanho de página fixo.
Dá para pesquisar o texto de um PDF feito de imagens?
Não. O documento contém fotos das suas páginas, então não há nada com que uma busca possa casar e nada para selecionar ou copiar. Transformar essas fotos em texto de verdade exige OCR, que precisa de um modelo treinado rodando num servidor ou baixado por inteiro. Um software que digitaliza direto para PDF com OCR é o caminho para um resultado pesquisável.
Por que minhas fotos aparecem giradas no PDF?
Os celulares salvam a foto na orientação do sensor e acrescentam uma tag EXIF dizendo quanto girar, e o PDF não tem uma tag equivalente. Um conversor que copia o arquivo sem ler essa tag deixa a foto deitada. Ler a tag e embutir a rotação na matriz que posiciona a imagem deixa a foto em pé sem recodificar nada.
Última atualização 21 de setembro de 2026