Convertir imágenes a PDF consiste en ordenarlas, elegir si cada página va a tener el tamaño de su imagen o va a ser una hoja A4 fija, y armar el archivo. Lo que eso cuesta depende por completo del conversor: casi todos decodifican tus fotos y las vuelven a comprimir en el camino, y ninguno tiene por qué hacerlo. Un PDF puede llevar los datos comprimidos de un JPEG byte por byte, tal como salieron de la cámara.
Por qué la mayoría de los conversores empeora tus fotos
La forma fácil de construir una herramienta así es decodificar cada imagen a píxeles, dibujarla en un canvas y codificar un JPEG nuevo con lo que quedó ahí. Un solo camino de código cubre todos los formatos de entrada, y por eso tantos programas funcionan así.
También tira detalle a la basura sin ganar nada. JPEG es un formato con pérdida: al codificar descarta lo que calcula que no vas a extrañar, y lo calcula sobre la imagen que tiene delante. Pasa una foto ya comprimida por una segunda codificación y esa pasada gasta su presupuesto en los artefactos de la primera. Los bordes ganan un halo tenue, el cielo plano se rompe en bloques más grandes, y el archivo no siempre queda más chico: una recodificación con una calidad más alta que la del original sale más grande.
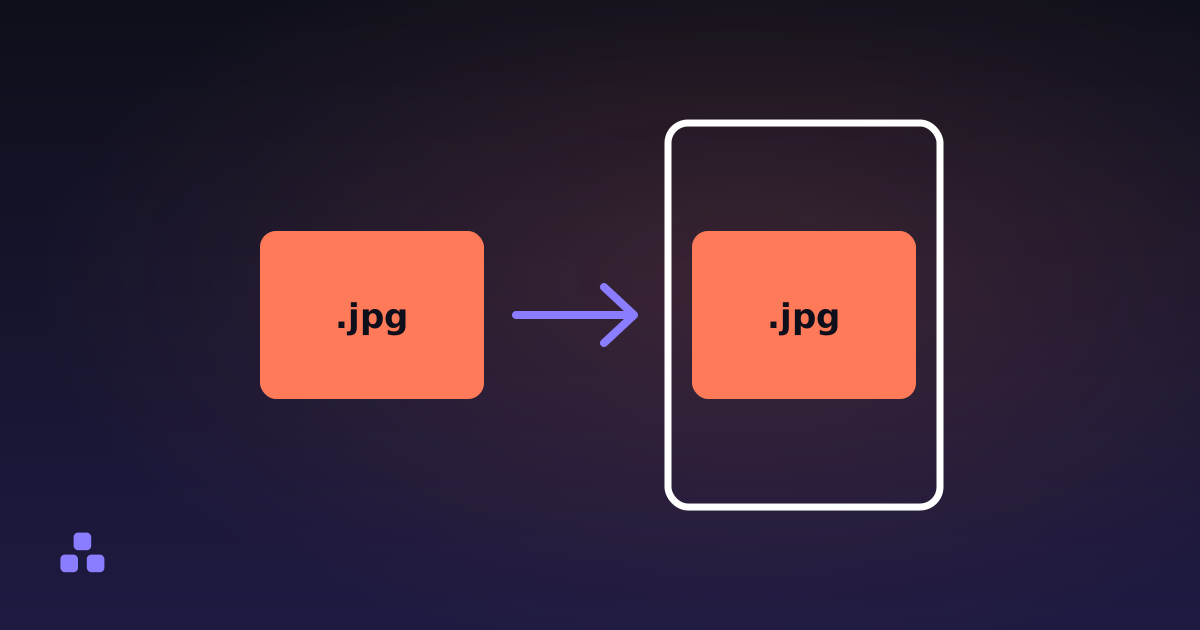
La solución no es un ajuste de calidad mejor. Es no recodificar. La herramienta de imágenes a PDF de aquí copia los datos comprimidos del JPEG directo al documento y marca cada archivo que trató así, para que veas qué imágenes entraron intactas y cuáles hubo que rehacer.
¿Cómo guarda un PDF un JPEG sin recodificarlo?
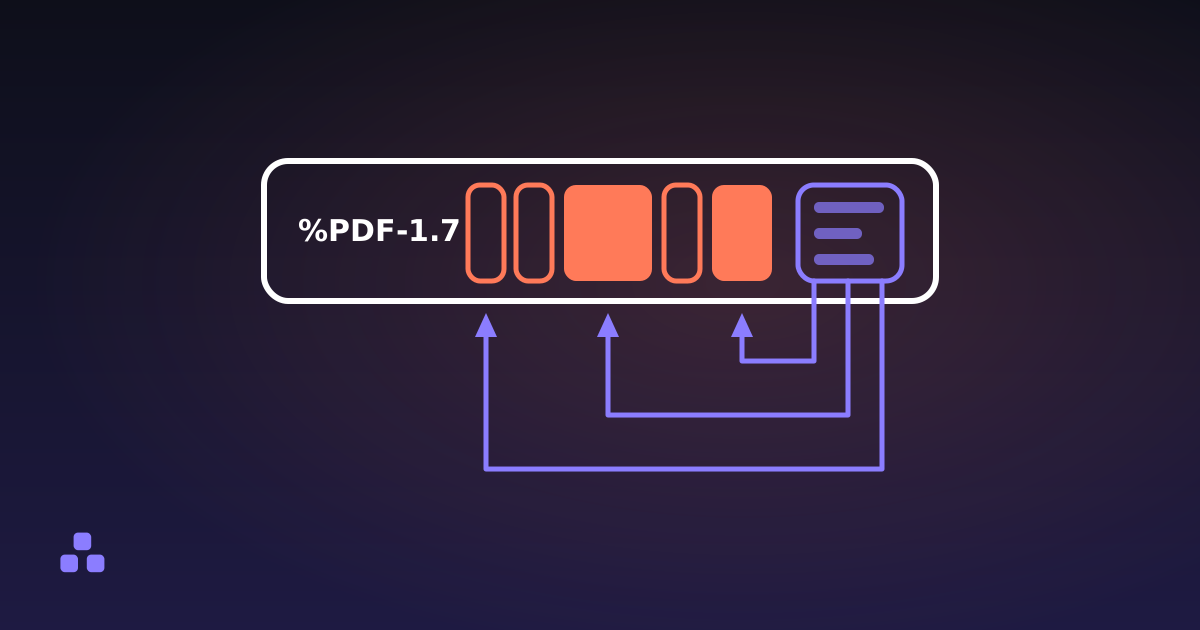
Una imagen dentro de un PDF no es parte de la página. Es un objeto aparte, un XObject, al que la página se refiere por nombre. La página lleva un MediaBox — cuatro números que dan las esquinas de la hoja en puntos — y un content stream, un programa muy corto que dice dibuja la imagen Im0, aquí, de este tamaño. Seis números, una matriz, y el dibujo está terminado. Qué hay realmente dentro de un archivo PDF desarma el resto de eso.
Cada objeto de imagen declara un filtro que dice cómo están comprimidos sus bytes, y uno de esos filtros es DCTDecode. DCTDecode es JPEG, y se llama así por la transformada discreta del coseno sobre la que está construido JPEG. Los datos comprimidos que hay dentro de un archivo .jpg son exactamente lo que espera un XObject de imagen: las tablas y el scan pasan tal como están, y solo se descartan los bloques de metadatos que los envuelven. No cambia ni un coeficiente, y el decodificador JPEG del propio visor hace el trabajo.
¿Qué JPEG pueden entrar intactos?
Casi todos, no todos. Pasan tal como están: JPEG baseline, secuencial extendido y progresivo a ocho bits por muestra, en escala de grises o en color. Esa es toda foto que hace un teléfono o una cámara común. No pasan: las muestras de doce bits, la codificación aritmética y los CMYK de cuatro canales de un flujo de imprenta. Un JPEG CMYK puede vivir dentro de un PDF, pero sus cuatro canales suelen estar guardados invertidos y el archivo no siempre lo aclara. Si eso se lee mal, la foto llega convertida en su propio negativo, así que esos se decodifican y se rehacen en RGB. Lo mismo pasa con cualquier JPEG cuyos marcadores dejan de tener sentido antes de que empiecen los datos de la imagen. Una imagen que el navegador no puede decodificar queda afuera con su nombre, y las demás páginas se arman igual.
¿Por qué un PNG no recibe el mismo trato?
En PDF no existe un filtro PNG. Lo más parecido es Flate, la misma compresión deflate sobre la que está construido PNG, y a la versión de PDF se le puede pedir que deshaga la predicción de filas de PNG: el truco por el cual cada fila se guarda como su diferencia con los píxeles de al lado y de arriba, que es buena parte de por qué PNG anda tan bien con el color plano y los bordes definidos. Así que un PNG simple y opaco podría entregarse, en principio, casi como se entrega un JPEG. Dos cosas lo rompen: un PNG entrelazado guarda sus filas mezcladas en siete pasadas, y uno con transparencia intercala el alfa con el color, mientras que PDF quiere el alfa como una imagen aparte en escala de grises.
Esta herramienta no intenta ese atajo. Un PNG se decodifica primero y después se guarda de una de dos formas honestas. Guardar los valores RGB exactos y comprimirlos con deflate, que no pierde nada y a menudo termina más grande que el propio PNG, porque el paso de predicción ya no está. O recodificar como JPEG, mucho más chico y con pérdida, justo sobre el tipo de imagen que lo delata: el texto y el dibujo lineal son donde peor se ven los artefactos de JPEG. La transparencia sigue el camino elegido — el sin pérdida la conserva como una máscara suave con el canal alfa, el de JPEG la aplasta contra blanco. WebP está en la misma situación.
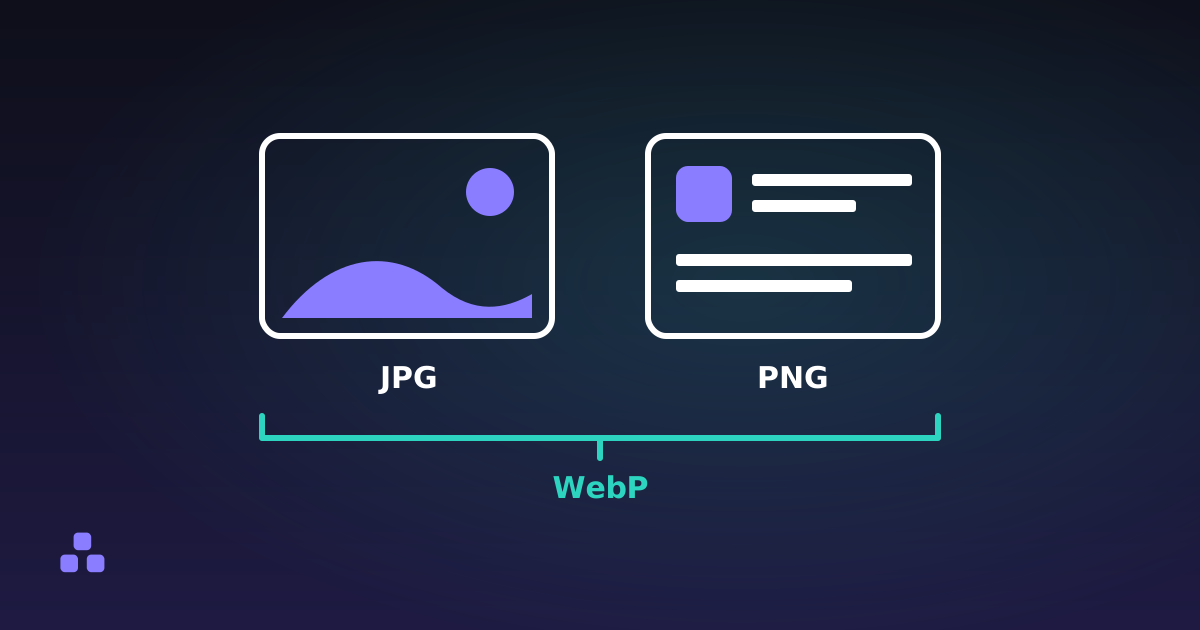
Si tus archivos son en realidad fotografías que terminaron guardadas como PNG, el arreglo está más arriba: PNG vs JPG vs WebP explica en qué formato va cada tipo de imagen. Una foto guardada como PNG es una forma habitual de terminar con un PDF varias veces más grande de lo necesario.
¿Qué hacen realmente el tamaño de página y los márgenes?
Ajustar a la imagen hace que cada página sea exactamente tan grande como su imagen, un píxel por punto. No se escala nada y no quedan bordes, que es lo que quieres en pantalla. Una captura de 1600 píxeles de ancho se convierte en una página de unas 22 pulgadas, lo que suena alarmante y casi nunca importa: un visor escala la página a la ventana y una impresora la escala al papel.
Un tamaño fijo, A4 o US Letter, es para un archivo que va a una impresora o a una pila de otros documentos. Ahí empieza a importar la relación de aspecto. A4 es más o menos 1:1,41, una foto de teléfono es 3:4, una captura tiene la forma de tu monitor. La imagen se escala hasta entrar, hacia arriba o hacia abajo, y se centra, así que el espacio que sobra se ve como barras blancas: a los costados cuando la imagen es proporcionalmente más ancha que la página, y arriba y abajo cuando es más alta. No se recorta ni se estira nada.
Los márgenes salen de esa caja antes del escalado, así que cada milímetro es una imagen un poco más chica; 10 mm es más o menos lo más cerca del borde que llega una impresora hogareña. En el modo ajustar a la imagen el margen agranda la página. Lo que nada de esto define es un DPI: los píxeles se guardan una sola vez y la página apenas registra de qué tamaño dibujarlos. Una imagen de 600 píxeles estirada sobre un A4 se imprime a unos 72 puntos por pulgada y se nota.
¿Qué define el peso de un PDF hecho de imágenes?
Casi por completo las imágenes. Los objetos de página, los content streams y la tabla de referencias cruzadas suman unos pocos cientos de bytes por página. Si el documento pesa 40 MB, metiste 40 MB de datos de imagen, y ningún ajuste del PDF va a cambiar eso.
La palanca está entonces más arriba, en las imágenes, antes de que se conviertan en páginas. Treinta fotos de teléfono de 4000 píxeles hacen un PDF enorme, se hayan recodificado o no, y si el archivo tiene que ir por correo, redimensionar y comprimir las imágenes primero logra mucho más que el paso de conversión. Comprimir una vez, a propósito, con una calidad que elegiste le gana a un conversor que lo hace en silencio con una que no elegiste.
¿Por qué las fotos del teléfono salen de costado?
Porque un teléfono guarda la foto como la vio el sensor y agrega una etiqueta EXIF chiquita que dice hacia dónde girarla. Tu aplicación de galería lee esa etiqueta; PDF no tiene equivalente, así que un conversor que copia los bytes sin leerla llena el documento de fotos acostadas. Por eso tantas herramientas recodifican todo. Hay una respuesta mejor: la rotación es una matriz, la colocación es una matriz, y multiplicarlas da una que hace las dos cosas.
El resto del bloque EXIF no viaja. Los datos de la imagen se copian byte por byte, pero los metadatos que los envuelven — coordenadas GPS, número de serie de la cámara, la miniatura incrustada — se descartan en el camino, porque ningún visor de PDF los mostraría y probablemente no querías mandarlos. Qué revela el EXIF de una foto vale la pena antes de compartir imágenes en algún lugar que los deje intactos.
Lo que un PDF hecho de imágenes nunca va a ser
Contiene fotos de páginas, no páginas de texto, y de ahí salen tres límites.
- Nada adentro se puede buscar. Ninguna palabra se selecciona, se busca ni se copia. Para que el texto sea texto de verdad hace falta OCR, que necesita un modelo entrenado corriendo en un servidor o descargado entero. Si vas a tener que buscar palabras en esos escaneos después, escanea directo a PDF con un programa que haga OCR.
- Qué formatos se abren depende de tu navegador. Safari lee HEIC; Chrome y Firefox en general no, y nada lee RAW de cámara. Un conversor que corre en tu propia máquina solo puede usar los decodificadores que esa máquina ya tiene.
- Los perfiles de color incrustados se descartan. Una imagen en Display P3 se vuelve a leer como sRGB: se nota en los colores saturados, es invisible en casi todo lo demás, y pasa por los dos caminos.
Si tienes imágenes para convertir en un documento ahora mismo, el conversor de imágenes a PDF hace todo lo anterior en tu navegador: los JPEG se copian intactos, la rotación EXIF se mete en la matriz de la página, y una línea por archivo dice cuáles pasaron tal como estaban. No se sube nada, así que las fotos nunca salen de tu computadora.
El paso siguiente suele ser unir el resultado con otra cosa, y cómo unir PDF sin subirlos a ningún lado es el mismo argumento en otro lugar: combinar documentos es otra operación que se puede hacer sin reescribir lo que ya tienen adentro.
Preguntas frecuentes
¿Cómo convierto imágenes a PDF?
Pon las imágenes en el orden que quieras, elige si cada página va a tener el tamaño de su imagen o va a ser una hoja fija A4 o US Letter, y arma el archivo. Una imagen se convierte en una página. La única decisión que afecta la calidad es si el conversor recodifica tus fotos o las copia tal como están.
¿Convertir una imagen a PDF reduce la calidad?
No tiene por qué. Un JPEG se puede copiar dentro de un PDF sin llegar a decodificarse, lo que deja la imagen idéntica bit a bit al archivo del que partiste. Un PNG o un WebP se decodifica primero y después se guarda como píxeles exactos, que no pierde nada pero da un archivo más grande, o se recodifica como JPEG, que es más chico y con pérdida.
¿Por qué mi PDF pesa más que las imágenes que metí?
Normalmente porque esas imágenes eran PNG o WebP. Guardarlas sin perder píxeles significa comprimir las muestras crudas con deflate, y deflate por sí solo comprime peor que PNG, que antes guarda cada fila como su diferencia con los píxeles de al lado y de arriba. Recodificarlas como JPEG achica mucho el archivo a cambio de algo de calidad.
¿Conviene elegir A4 o ajustar a la imagen en el tamaño de página?
Elige ajustar a la imagen cuando el archivo es para leer en pantalla y no quieres bordes, porque ahí cada página coincide exacto con su imagen. Elige A4 o US Letter cuando el archivo va a una impresora o a una pila de otros documentos y todas las hojas tienen que medir lo mismo. Los márgenes recién tienen sentido con un tamaño de página fijo.
¿Puedo buscar el texto de un PDF hecho con imágenes?
No. El documento contiene fotos de tus páginas, así que no hay nada con lo que una búsqueda pueda coincidir ni nada para seleccionar o copiar. Convertir esas fotos en texto real requiere OCR, que necesita un modelo entrenado corriendo en un servidor o descargado entero. Un programa que escanea directo a PDF con OCR es la forma de obtener un resultado buscable.
¿Por qué mis fotos salen rotadas en el PDF?
Los teléfonos guardan la foto en la orientación del sensor y agregan una etiqueta EXIF que dice cuánto hay que girarla, y PDF no tiene una etiqueta equivalente. Un conversor que copia el archivo sin leer esa etiqueta deja la foto de costado. Leer la etiqueta y meter la rotación dentro de la matriz que coloca la imagen deja la foto derecha sin recodificarla.
Última actualización 21 de septiembre de 2026