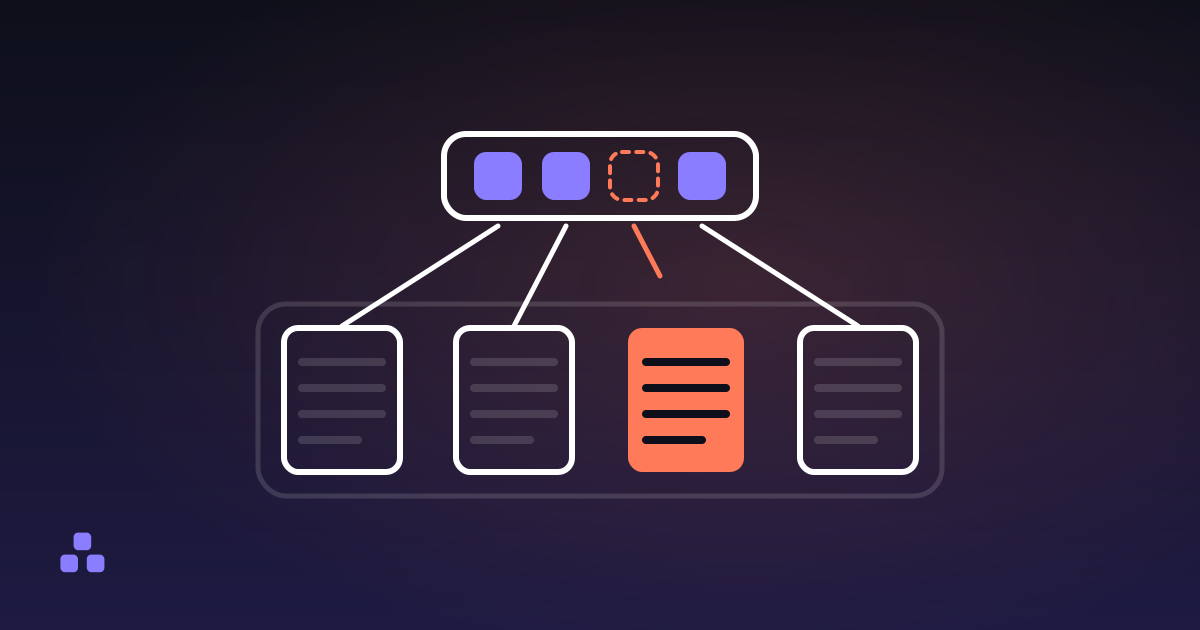
Para eliminar páginas de un PDF, abre el archivo en una herramienta que lo reescriba, indica las páginas que sobran — 2, 5-7, 12- — y guarda lo que queda. Esa parte lleva diez segundos. La parte que nadie menciona es que eliminar una página y eliminar su contenido son dos operaciones distintas en un PDF, y una herramienta puede hacer la primera sin la segunda. La página desaparece de todos los visores, los bytes se quedan en el archivo, y el documento que acabas de mandar por correo sigue llevando la página que creías haber eliminado.
¿Dónde está guardada realmente una página?
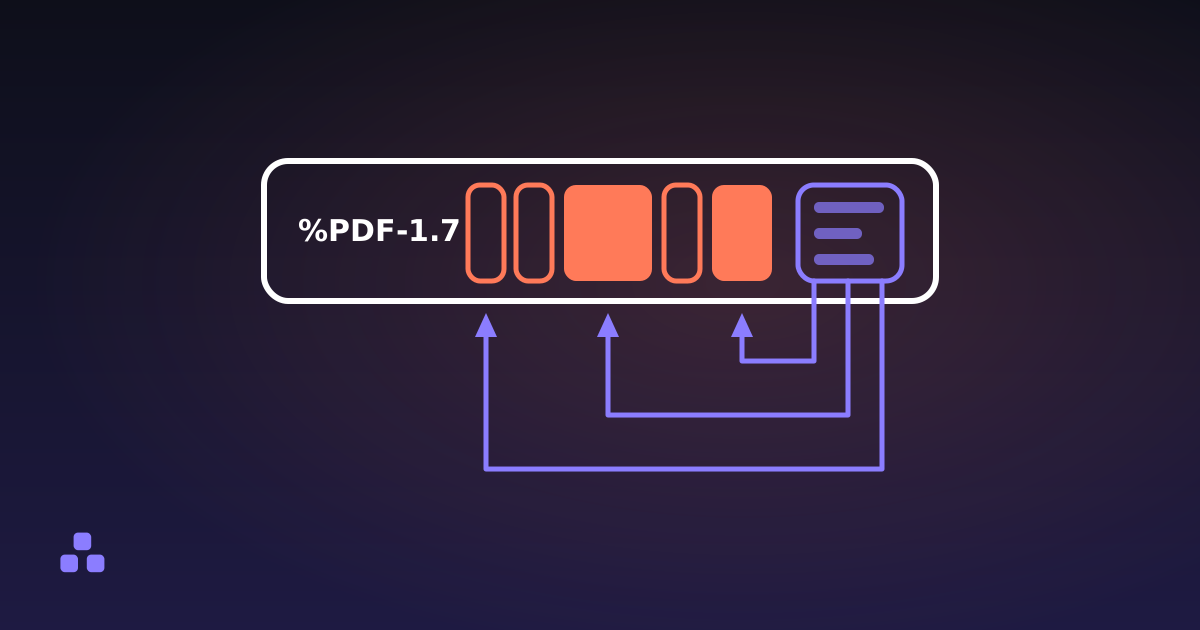
No en una pila. Un PDF es un montón de objetos numerados —diccionarios, arreglos y flujos comprimidos de instrucciones de dibujo— indexados por una tabla al final que anota en qué byte empieza cada uno. Nada se guarda en orden de lectura: un lector encuentra la página 400 siguiendo el catálogo hasta el árbol de páginas, recorriéndolo hasta la hoja número cuatrocientos y saltando al byte anotado para ella. Qué hay realmente dentro de un archivo PDF desarma esa estructura objeto por objeto; acá importa un solo nivel.
Una página pertenece al documento porque una lista la nombra. El árbol de páginas es un nodo con un arreglo de hijos, y cada hijo es otro nodo o un diccionario de página, que apunta al flujo de contenido que dibuja la página y a las fuentes e imágenes que necesita. Saca la página de ese arreglo, corrige el conteo del nodo de arriba, y todos los lectores del mundo te muestran una página menos. No tocaste el diccionario de la página ni su flujo de contenido. Editaste una lista.
Qué significa "sin referencia" y por qué el contenido sobrevive
Un objeto al que nada apunta sigue siendo un objeto del archivo. Tiene su número, tiene su entrada en la tabla de referencias cruzadas, y está en el flujo de bytes exactamente donde siempre estuvo. Los visores nunca lo dibujan, porque un visor solo dibuja lo que alcanza el árbol de páginas. Otras cosas lo encuentran fácil: un extractor de texto que recorre objetos en vez del árbol saca las palabras, y un descompresor lo deja a la vista.
Escribir solamente los objetos alcanzables —una pasada de recolección de basura— es trabajo corriente para una biblioteca de PDF, y las cuidadosas lo hacen. Pero es trabajo extra, se puede saltear, y el archivo que produce se abre igualito que el archivo que se guardó todo. Nada en el formato exige esa pasada, y nada en tu visor te dice cuál de los dos archivos tienes en la mano.
La otra forma en que una página eliminada se queda: el guardado incremental
El PDF tiene una segunda característica que produce el mismo resultado por diseño. Un archivo se puede actualizar agregando al final: el editor escribe los objetos que cambiaron después de los bytes existentes, suma una sección de referencias cruzadas que apunta a ellos, y termina con un tráiler nuevo. El archivo original de abajo queda intacto. La sección nueva dice que el árbol de páginas ahora es este otro objeto — y el árbol viejo, las páginas viejas y todos los flujos de contenido que usaban siguen ahí, en los primeros no sé cuántos megabytes.
Esto no es un defecto: un guardado incremental tarda lo mismo pese lo que pese el archivo, y una firma aplicada a una revisión anterior solo sobrevive porque los bytes firmados siguen ahí. El peligro está en la palabra "guardar", que la gente lee razonablemente como "el archivo ahora contiene lo que veo".
¿Cómo compruebo si la página desapareció de verdad?
Cuenta las marcas %%EOF. Cada sección de referencias cruzadas termina en una, y guardar encima de un archivo que ya existe agrega una sección en lugar de reemplazarla. Abre el PDF en un editor de texto plano y busca esa cadena. Una sola marca significa una sola sección, sin nada debajo. Más de una tiene dos causas, y dónde está la marca de más te dice cuál: un archivo linealizado, armado para la vista web rápida, lleva una segunda sección dentro de los primeros kilobytes, mientras que cada guardado posterior deja su marca al final de los bytes que agregó. Dos marcas con la primera cerca del principio son un archivo linealizado normal. Cualquier otra cosa significa que adentro siguen versiones anteriores del documento.
Mira el tamaño. Un archivo que perdió la mitad de sus páginas y ni un byte te está diciendo algo. Eso sí, no leas lo contrario con demasiada confianza: incluso una reescritura limpia casi nunca se achica en la misma proporción de páginas que sacaste, porque la fuente incrustada y el logo que aparecía en todas las páginas estaban guardados una sola vez y se quedan por las páginas que conservaste. La mitad de las páginas fuera y apenas una parte de los bytes fuera es lo corriente; la mitad de las páginas fuera y ni un byte, no.
Descomprímelo y busca. El contenido de las páginas vive en flujos comprimidos, así que buscar en el archivo crudo una frase de la página eliminada normalmente no encuentra nada, esté la página o no. El comando qpdf --qdf --preserve-unreferenced in.pdf out.pdf reescribe el documento con los flujos expandidos y dispuesto para leerse. La segunda opción es la que importa acá: sin ella, qpdf descarta los objetos a los que nada apunta, que son justo los que viniste a buscar. Busca en esa copia una frase que hayas eliminado; si aparece, la página también apareció. Esto encuentra los huérfanos que el índice todavía lista: el contenido varado en una revisión anterior es lo que atrapa el conteo de marcas.
Lo que no puedes hacer es juzgar abriendo el archivo: todos estos documentos se ven correctos en un visor, y ese es el problema entero. Un lector de estructura responde en cambio las preguntas normales — el inspector de PDF de acá informa el número de páginas, el tamaño y la rotación de cada una, qué programa lo escribió y si una página está recortada. El recorte es su propia versión de esta trampa: una caja de recorte le dice al visor qué parte de la hoja mostrar y no quita nada.
Cómo se ve una eliminación limpia
La operación segura no es "saca estas páginas" sino "escribe un documento nuevo que contenga solo las páginas que conservo". Copia cada página sobreviviente a un archivo vacío con todo su grafo de referencias —las fuentes que usa, las imágenes que dibuja, las anotaciones de encima—, renumera esos objetos, escribe una tabla de referencias cruzadas fresca, y para. Las páginas eliminadas no se quitan, porque nunca se copiaron, y no hay una revisión anterior debajo, porque el archivo es nuevo.
Hay una forma de hacer eso mal, y parece meticulosidad. Una página que conservaste puede llevar un enlace cuyo destino es una página que eliminaste. Un copiador que sigue cada referencia que se le cruza baja por ese enlace, copia el diccionario y el flujo de contenido de la página eliminada al archivo nuevo, y los deja colgando de nada: el árbol de páginas dice que la página no está y los bytes dicen otra cosa. La salida es tratar una referencia a una página como una reserva: apartar un número de objeto, llenarlo solo si esa página se agrega, y descartar el enlace si nunca se agrega.
Así funciona el eliminador de páginas de este sitio: escribes las páginas o les haces clic en una fila numerada, y arma la salida a partir de las sobrevivientes. No hay miniaturas, porque dibujarlas significa mandarle un motor de renderizado a cada persona que abre la página, así que informa el número de páginas y el tamaño y la rotación de cada una. Corre por completo en tu navegador, así que el documento que estabas por mandar por correo tampoco se sube a ningún lado, y las páginas que conservas se copian byte por byte con la compresión que ya traían.
Qué te cuesta la reescritura
Construir un archivo nuevo es el intercambio correcto, pero es un intercambio. Lo que vive a nivel del documento y no sobre una página no sobrevive:
- Marcadores y etiquetas de página. El índice lateral desaparece, y un archivo numerado i, ii, 1, 2 vuelve numerado 1, 2, 3, 4.
- El comportamiento de los formularios. Los campos se siguen dibujando, porque sus widgets están sobre las páginas, pero el diccionario de formulario del documento se pierde y llegan inertes.
- Las firmas digitales. Una firma cubre una secuencia concreta de bytes, así que cualquier reescritura la invalida. No hay nada que hacer salvo volver a firmar después.
- Los enlaces escritos como nombre. Un enlace que apunta a un nombre se resuelve a través de una tabla del catálogo, y un archivo nuevo no hereda esa tabla. Uno que apunta directo a un objeto de página anda bien en los dos sentidos, mientras la página que nombra haya sobrevivido; un enlace a una página que eliminaste se descarta junto con ella.
Los números impresos en las páginas tampoco cambian. El "23" de un pie de página es texto dibujado dentro del flujo de contenido de esa página, y nada en el archivo sabe que es un número: renumerar significaría volver a componer la página. Y si quieres conservar esas páginas en lugar de tirarlas, la operación es otra: dividir un PDF en archivos separados conserva todo y solo lo reparte.
Eliminar una página no es tachar información
Todo lo anterior trata de una página que quieres fuera por completo. Si lo delicado es un nombre o un párrafo de una página que vas a conservar, eliminar páginas no te sirve de nada — y los dos trucos a los que la gente recurre en su lugar, tampoco. Un rectángulo negro dibujado sobre un texto es un rectángulo dibujado sobre un texto: los caracteres siguen abajo, en el flujo de contenido, y seleccionar esa zona los copia. Recortar es peor, porque se siente permanente mientras no quita nada. Tachar de verdad borra los caracteres del flujo mismo, otro trabajo que conviene hacer con software dedicado. El fracaso se ve idéntico al éxito siempre: la página se ve limpia, y el archivo no lo está.
Si tienes un archivo que arreglar y no un mecanismo que entender, el eliminador de páginas de PDF toma los números o los clics, arma un documento nuevo con las páginas que conservas y lo descarga sin que el archivo salga nunca de tu máquina. No abre PDFs protegidos con contraseña y pierde los marcadores, así que revisa el resultado cuando la estructura del documento importe tanto como su lista de páginas.
Y si lo que se te quedó dando vueltas fue la estructura —los objetos, la tabla de referencias cruzadas, por qué una página es una entrada de una lista y no una página— qué hay realmente dentro de un archivo PDF es la versión larga. Explica también casi todas las demás sorpresas del formato, incluida la razón por la que un PDF que se ve bien puede estar técnicamente roto y abrirse en todos lados igual.
Preguntas frecuentes
¿Eliminar una página de un PDF borra de verdad su contenido?
No siempre. Una página se puede sacar del árbol de páginas mientras su diccionario y su flujo de contenido se quedan en el archivo como objetos sin referencia, que ningún visor dibuja pero cualquier extractor de texto encuentra. Depende por completo de si la herramienta reescribe el documento o solo edita la lista de páginas. Una herramienta que construye un archivo nuevo con las páginas que conservas es la clase segura, siempre que no siga un enlace de una página conservada hacia una eliminada y copie también esa página.
¿Cómo sé si una página eliminada sigue dentro del PDF?
Abre el archivo en un editor de texto plano y cuenta las marcas %%EOF. Una sola significa una sola pasada, sin nada debajo; una segunda dentro de los primeros kilobytes es la linealización normal, y cualquier marca más adentro es una revisión anterior que sigue ahí. Para una respuesta definitiva, pásale qpdf --qdf --preserve-unreferenced para expandir los flujos y conservar los objetos a los que nada apunta, y después busca en el resultado una frase de la página que eliminaste. Si el texto está, la página también.
¿Por qué mi PDF pesa lo mismo después de eliminar páginas?
O las páginas se sacaron de la lista sin sacarlas del archivo, o el editor agregó el cambio al final en lugar de reescribir el documento. Que se achique menos que la proporción de páginas eliminadas es normal, porque las fuentes y los logos compartidos entre páginas se guardan una sola vez y se quedan. Que no se achique nada es una señal de alerta que conviene revisar.
¿Cómo elimino páginas de un PDF gratis y sin instalar nada?
Usa una herramienta de navegador que procese el archivo localmente, como el eliminador de páginas de este sitio: suelta el PDF, escribe las páginas a eliminar como números sueltos o rangos, y descarga lo que queda. No se sube nada y no hace falta una cuenta. La excepción son los archivos protegidos con contraseña: esos hay que desbloquearlos primero en el programa que los protegió.
¿Eliminar una página es lo mismo que tachar información?
No. Eliminar saca una página entera, y solo del todo si la herramienta reescribe el archivo. Tachar quita contenido puntual de una página que vas a conservar, lo que implica editar el flujo de contenido en sí. Dibujar una caja negra sobre un texto o recortar la página lo esconde en pantalla y deja cada carácter en su lugar.
¿Se actualizan los números de página impresos después de eliminar una página?
No. Los números de página de los encabezados y los pies son texto dibujado dentro del flujo de contenido de cada página, y nada en el archivo los marca como números de página. Después de eliminar la página 5, todos los pies posteriores quedan corridos por uno, y un índice sigue apuntando a la numeración vieja. Volver a exportar desde el programa que creó el documento es el único arreglo real.
Última actualización 21 de septiembre de 2026