O Base32 transforma bytes quaisquer em texto usando apenas 32 caracteres — as letras de A a Z e os dígitos de 2 a 7 — de modo que o resultado sobrevive a ser lido em voz alta, digitado no teclado de um celular ou copiado à mão sem os dois erros que arruínam uma string assim: trocar uma letra por um dígito parecido, ou perder de vista se algo era maiúsculo ou minúsculo. Um segredo de dois fatores está em base32 exatamente por isso, e assim que você conhece essa forma, começa a notá-la em mais alguns lugares.
Como o Base32 transforma bytes em letras?
O Base64 encaixa seis bits em um caractere, porque 26 = 64. O Base32 encaixa só cinco, porque 25 = 32, então cinco bytes — 40 bits — se dividem exatamente em oito caracteres de base32, sem sobrar nada. Qualquer coisa mais curta que um múltiplo de cinco bytes recebe preenchimento com sinais = para que o comprimento da saída continue múltiplo de oito: um byte sobrando preenche com seis =, dois bytes sobrando preenchem com quatro, três preenchem com três, quatro preenchem com um. A RFC 4648, que padronizou o formato em outubro de 2006 e substituiu a RFC 3548 anterior, detalha exatamente essa tabela.
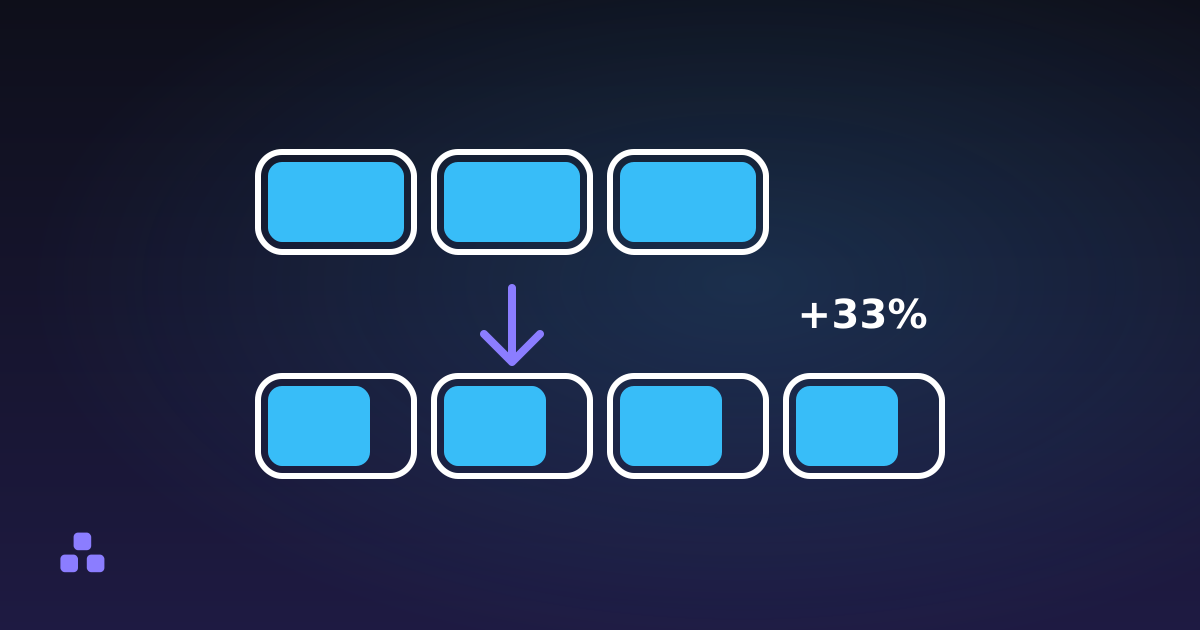
O alfabeto mais estreito custa tamanho. O Base64 precisa de quatro caracteres para cada três bytes: 1,33 caractere por byte. O Base32 precisa de oito caracteres para cada cinco bytes: 1,6 caractere por byte, cerca de 20% mais texto para os mesmos dados. Um segredo de 20 bytes, o tamanho usual de uma chave TOTP, vira 27 caracteres em Base64 e 32 em Base32. Você consegue ver a metade dessa conta referente ao Base64 direto em o codificador de Base64 daqui: cole 20 caracteres de texto e veja a saída crescer um terço em vez de três quintos.
Por que o alfabeto pula o 0, o 1, o 8 e o 9?
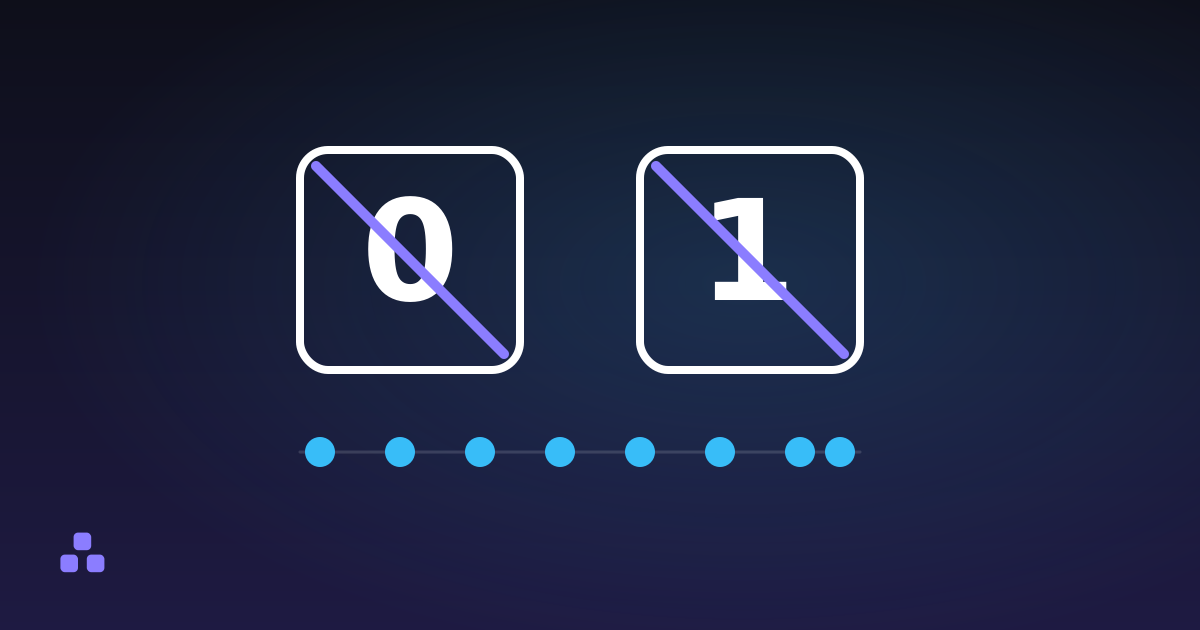
Os 32 caracteres do Base32 são as 26 letras mais seis dígitos, e a RFC 4648 escolhe de 2 a 7 em vez de qualquer outra sequência. Essa escolha não é arbitrária: ela remove o 0 e o 1, os dois dígitos que as pessoas mais confundem com uma letra — o 0 com a letra O, o 1 com a letra I ou um L minúsculo — enquanto mantém no alfabeto todas as letras, inclusive a O, a I e a L. Como os dígitos que poderiam ser confundidos com elas simplesmente nunca são usados, não existe ambiguidade real: um O numa string base32 só pode ser a letra, porque um zero nunca aparece ali. O 8 e o 9 também ficam de fora, embora não por um motivo de confusão — o formato só precisa de seis dígitos para chegar a 32 símbolos, e de 2 a 7 foi a sequência escolhida.
Por que o seu segredo de dois fatores é Base32 e não Base64?
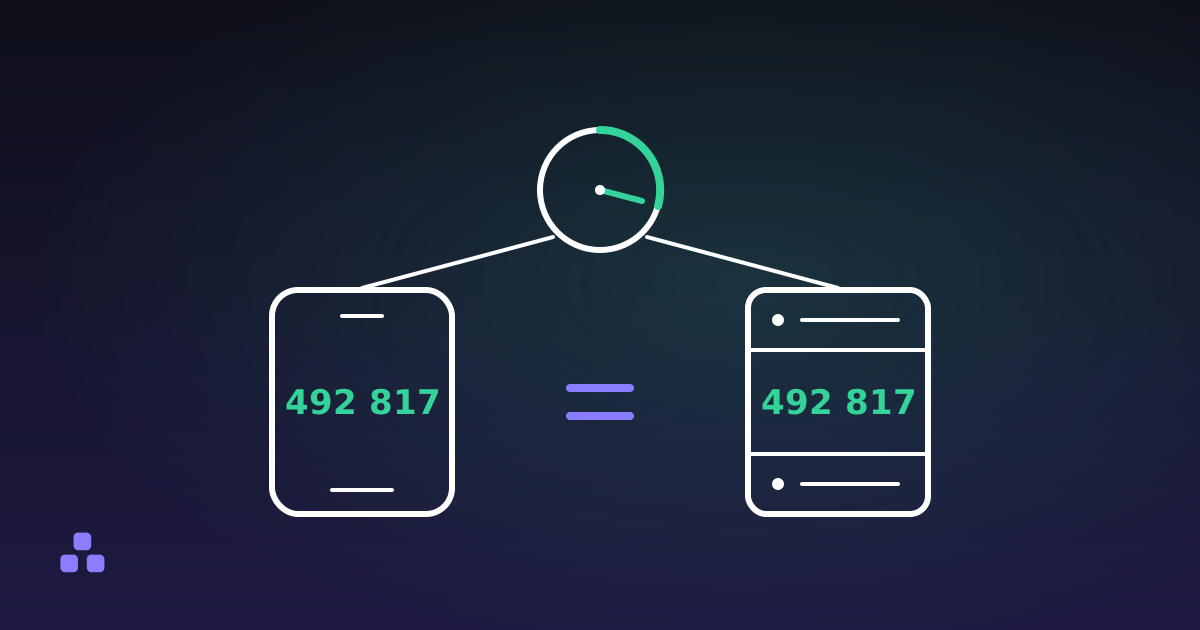
Um segredo TOTP normalmente são 20 bytes aleatórios que uma pessoa precisa digitar pelo menos uma vez — num gerenciador de senhas, num segundo aparelho ou numa nota de recuperação —, quase sempre lendo de uma tela. O alfabeto do Base64 inclui as duas formas de cada letra, então um a minúsculo e um A maiúsculo são símbolos diferentes, e errar um deles muda o segredo em silêncio. O Base32 evita isso: a RFC 4648 declara como objetivo do formato um que "precisa ser insensível a maiúsculas e minúsculas", então um codificador canônico emite maiúsculas e um decodificador bem feito trata jbswy3dp e JBSWY3DP como a mesma entrada. Cole um segredo em o gerador de TOTP daqui e você consegue ver essa decodificação acontecendo ao vivo — espaços e minúsculas são aceitos, e um caractere fora do alfabeto é recusado pelo nome em vez de ser corrompido em silêncio.
É também por isso que a aritmética por trás desses seis dígitos começa de uma string em base32 e não em base64: o segredo precisa sobreviver a uma pessoa digitando ele, e o bit extra por caractere do base64 é desperdiçado num trabalho feito uma única vez, de viva voz ou à mão, em vez de milhões de vezes por uma máquina.
O Base32 é o mesmo em todo lugar?
Não, e é aqui que a palavra "base32" fica escorregadia. Só a RFC 4648 já define dois alfabetos diferentes sob esse nome:
- O alfabeto padrão — de A a Z e depois de 2 a 7 — é o que segredos TOTP e a maioria das bibliotecas de base32 de uso geral usam.
- base32hex — de 0 a 9 e depois de A a V — reordena os mesmos 32 símbolos para que ordenar o texto codificado byte a byte devolva a mesma ordem de ordenar os bytes originais. Os registros NSEC3 do DNSSEC dependem exatamente dessa propriedade para provar que um nome de domínio não existe sem precisar listar todos os que existem.
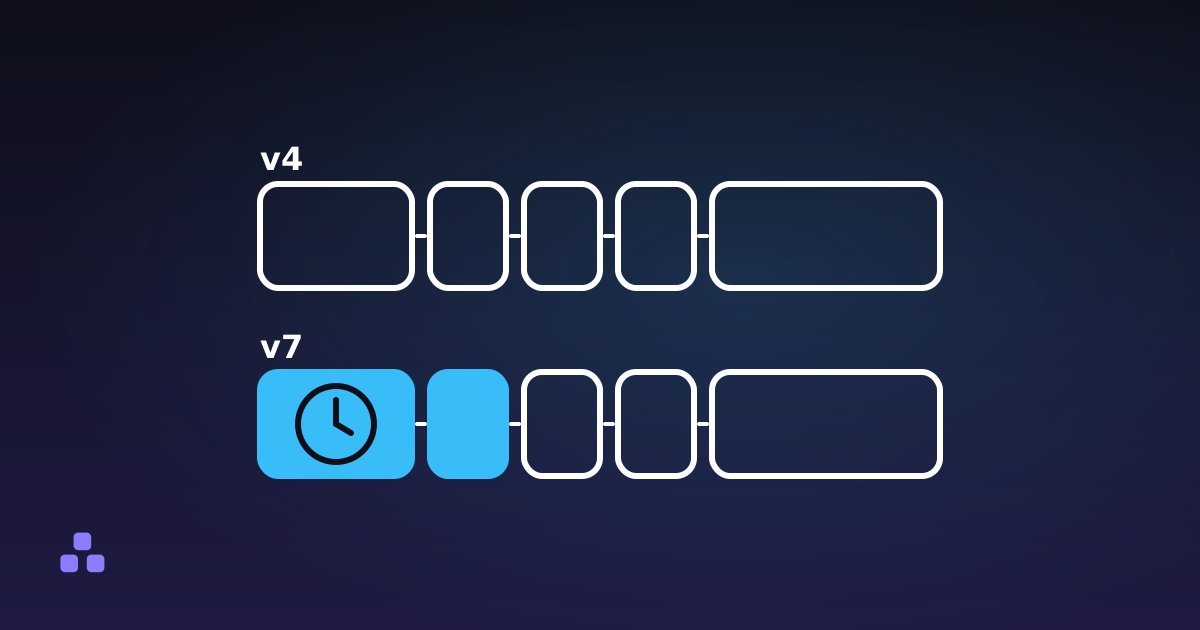
Fora da RFC, o base32 de Crockford é um terceiro design, incompatível com os outros dois: ele remove por completo as letras I, L, O e U do alfabeto — I e L por se parecerem com 1, O por se parecer com 0, U para evitar uma palavra sem querer — e mantém os dígitos 0 e 1 em vez de excluí-los como faz a RFC 4648. A decodificação é tolerante de propósito: um I ou um L, maiúsculo ou minúsculo, é lido de volta como 1, e um O é lido de volta como 0. Ele também define um símbolo de verificação opcional no final para pegar um único caractere digitado errado, algo que a RFC 4648 não tem de forma nenhuma. O ULID, um identificador ordenável parente do UUID v7, é escrito em base32 de Crockford — a mesma ideia do timestamp de 48 bits do UUID v7, só que soletrada com outro alfabeto. Um software feito para uma variante de base32 não necessariamente lê a outra, então vale a pena conferir o alfabeto antes de supor que duas strings "base32" são compatíveis.
Onde mais o Base32 aparece?
Além dos segredos de dois fatores, três lugares que vale a pena reconhecer:
- Os endereços onion do Tor. Um endereço
.onionv3 é a chave pública Ed25519 de 32 bytes de um site, uma versão de um byte e um checksum de dois bytes, tudo passado por base32 — por isso todo endereço onion tem exatamente 56 caracteres antes do sufixo.onion. - Os registros NSEC3 do DNSSEC, que guardam um nome de domínio com hash usando base32hex justamente porque isso preserva a ordem.
- Os ULIDs, na variante de Crockford, em qualquer aplicação que queira um identificador parecido com UUID, mas mais curto de digitar e sem diferenciar maiúsculas.
O que o Base32 não consegue fazer por você
Não é compressão: cinco bits de alfabeto por caractere significa que a forma codificada é sempre maior que a entrada, nunca menor. Também não é criptografia: assim como o Base64, ele não tem chave, e qualquer um que tenha uma string base32 consegue decodificá-la em um passo, sem precisar de nenhum segredo. E não valida nada sozinho: um segredo base32 corrompido, com um caractere trocado por outro, ainda decodifica em 20 bytes, só que os 20 bytes errados, e nada no formato em si avisa que isso aconteceu. Só o símbolo de verificação opcional do Crockford resolve isso, e o base32 da RFC 4648 — o que existe por trás do seu segredo de dois fatores — não tem nada parecido.
A ferramenta mais diretamente envolvida em tudo isso é o gerador de TOTP: cole um segredo em base32 nele e ele decodifica o alfabeto na sua frente, com contagem de bytes incluída, a mesma decodificação que um app autenticador de verdade faz antes mesmo de tocar no HMAC. Nada é enviado nem salvo — recarregue a página e o segredo some.
Se os seis dígitos que saem do outro lado são a parte que você realmente queria ver explicada, como esses códigos são calculados a partir do segredo decodificado continua exatamente de onde este texto para.
Perguntas frequentes
Para que o Base32 é usado?
Principalmente para valores que uma pessoa pode precisar digitar, ler em voz alta ou comparar a olho: segredos de autenticação de dois fatores, endereços onion do Tor e identificadores ordenáveis como o ULID. Em qualquer lugar onde um valor só vá ser lido por uma máquina, o Base64 costuma ser a escolha melhor, porque coloca mais informação em menos caracteres.
O Base32 diferencia maiúsculas de minúsculas?
A RFC que o padroniza busca um formato que não precise preservar a diferença entre maiúsculas e minúsculas, então um codificador de acordo com o padrão sempre produz maiúsculas e um decodificador bem feito também aceita minúsculas. Nem toda implementação é assim tolerante, então, se uma string Base32 for recusada, vale tentar em maiúsculas antes de supor que o valor em si está errado.
Por que uma string Base32 é mais longa que a Base64 equivalente?
Porque cada caractere do Base32 carrega 5 bits de informação contra os 6 do Base64, então os mesmos dados precisam de cerca de 20% mais caracteres em Base32. Um segredo de 20 bytes sai como 32 caracteres em Base32 ou 27 em Base64 — o preço de um alfabeto feito para sobreviver a ser copiado à mão em vez de lido por um parser.
Qual é a diferença entre o Base32 padrão e o Base32 de Crockford?
O Base32 padrão, da RFC 4648, usa de A a Z e de 2 a 7, e mantém todas as letras, inclusive as que se parecem com dígitos. O Base32 de Crockford, usado por identificadores como o ULID, faz o oposto: mantém o 0 e o 1, mas remove as letras I, L, O e U, e seu decodificador perdoa automaticamente algumas confusões comuns. Os dois alfabetos não são intercambiáveis.
Uma string Base32 pode ser corrigida automaticamente se um caractere estiver errado?
Só se o software usar a variante de Crockford, que traduz de volta alguns caracteres comumente digitados errado e aceita um caractere de verificação opcional para pegar o resto. O base32 da RFC 4648 — o que existe por trás de um segredo de dois fatores — não tem nenhum dos dois: um caractere errado ou é recusado direto, ou é decodificado em silêncio nos bytes errados.
Última atualização 27 de setembro de 2026