Base32 convierte bytes cualquiera en texto usando solo 32 caracteres —las letras de la A a la Z y los dígitos del 2 al 7— de modo que el resultado sobrevive a leerse en voz alta, escribirse en el teclado de un teléfono o copiarse a mano sin los dos errores que arruinan una cadena así: confundir una letra con un dígito parecido, o perder de vista si algo iba en mayúscula o en minúscula. Un secreto de dos factores está en base32 exactamente por eso, y en cuanto conoces su forma empiezas a notarlo en algunos lugares más.
¿Cómo convierte Base32 los bytes en letras?
Base64 mete seis bits en un carácter, porque 26 = 64. Base32 mete solo cinco, porque 25 = 32, así que cinco bytes —40 bits— se dividen exactamente en ocho caracteres de base32 sin que sobre nada. Todo lo que sea más corto que un múltiplo de cinco bytes se rellena con signos = para que la longitud de la salida se mantenga como múltiplo de ocho: un byte sobrante rellena con seis =, dos bytes sobrantes rellenan con cuatro, tres rellenan con tres, cuatro rellenan con uno. El RFC 4648, que estandarizó el formato en octubre de 2006 y reemplazó al RFC 3548 anterior, detalla exactamente esa tabla.
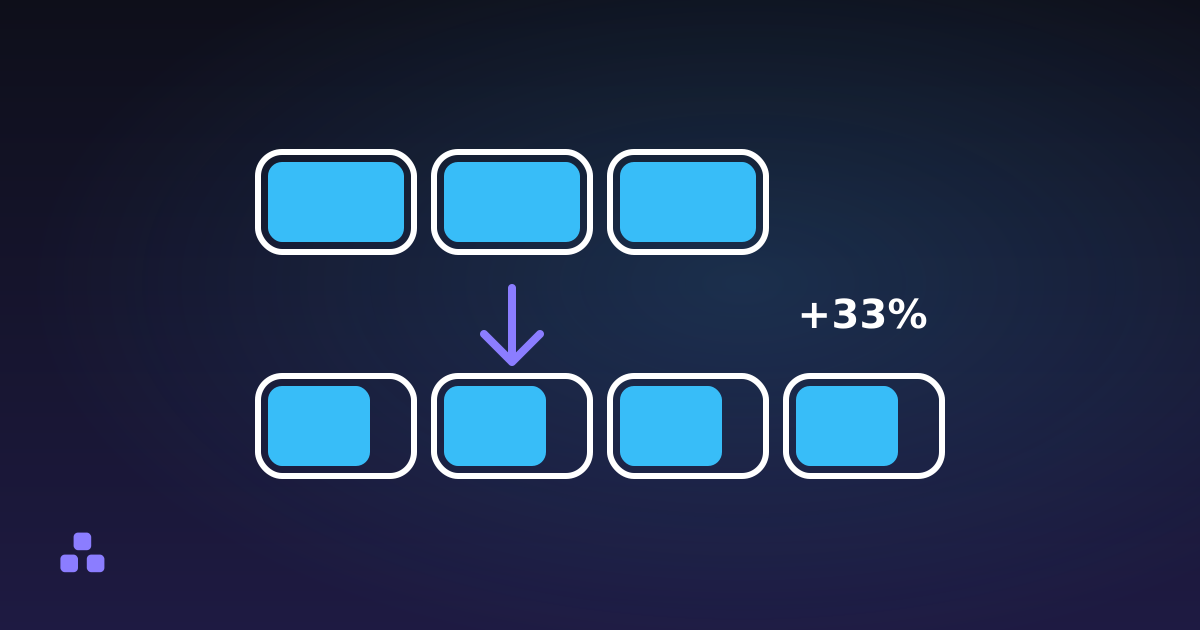
El alfabeto más angosto cuesta tamaño. Base64 necesita cuatro caracteres por cada tres bytes: 1,33 caracteres por byte. Base32 necesita ocho caracteres por cada cinco bytes: 1,6 caracteres por byte, alrededor de un 20% más de texto para los mismos datos. Un secreto de 20 bytes, el tamaño habitual de una clave TOTP, se convierte en 27 caracteres en Base64 y en 32 en Base32. Puedes ver la mitad de esa cuenta correspondiente a Base64 directamente en el codificador de Base64 de aquí: pega 20 caracteres de texto y mira cómo la salida crece un tercio en vez de tres quintos.
¿Por qué el alfabeto se salta el 0, el 1, el 8 y el 9?
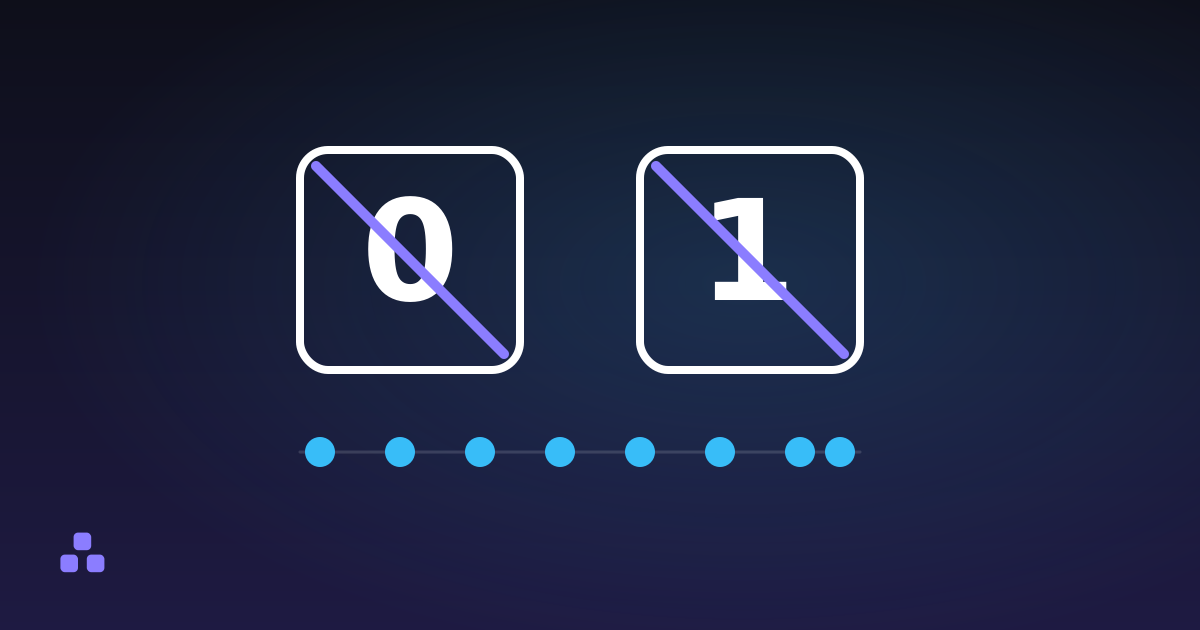
Los 32 caracteres de Base32 son las 26 letras más seis dígitos, y el RFC 4648 elige del 2 al 7 y no cualquier otra tanda. Esa elección no es arbitraria: elimina el 0 y el 1, los dos dígitos que la gente confunde más con una letra —el 0 con la letra O, el 1 con la letra I o con una ele minúscula— mientras deja en el alfabeto cada letra, incluidas la O, la I y la L. Como los dígitos que podrían confundirse con ellas simplemente no se usan nunca, no hay ambigüedad real: una O en una cadena base32 tiene que ser la letra, porque ahí nunca aparece un cero. El 8 y el 9 también quedan afuera, aunque no por una razón de confusión: el formato solo necesita seis dígitos para llegar a 32 símbolos, y del 2 al 7 es la tanda que se eligió.
¿Por qué tu secreto de dos factores está en Base32 y no en Base64?
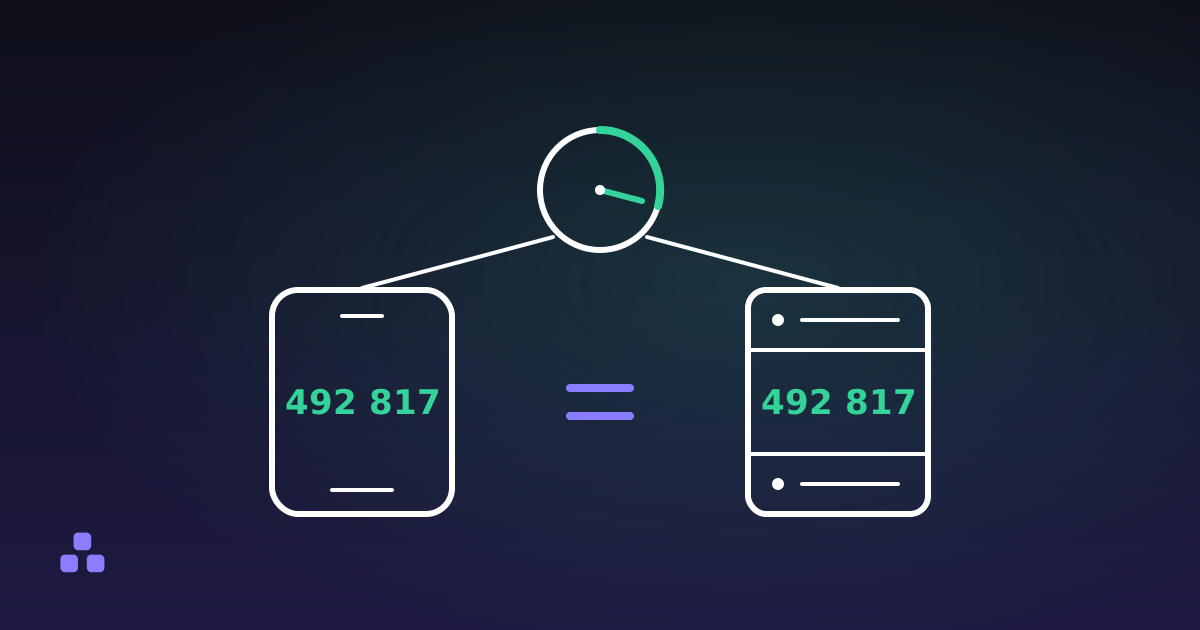
Un secreto TOTP normalmente son 20 bytes aleatorios que una persona tiene que escribir al menos una vez —en un gestor de contraseñas, en un segundo dispositivo o en una nota de recuperación—, casi siempre leyéndolo de una pantalla. El alfabeto de Base64 incluye las dos formas de cada letra, así que una a minúscula y una A mayúscula son símbolos distintos, y escribir mal una de las dos cambia el secreto en silencio. Base32 evita eso: el RFC 4648 declara como objetivo del formato uno que "necesita ser insensible a mayúsculas", así que un codificador canónico emite mayúsculas y un decodificador bien hecho trata jbswy3dp y JBSWY3DP como la misma entrada. Pega un secreto en el generador de TOTP de aquí y puedes ver esa decodificación en vivo: los espacios y las minúsculas se aceptan, y un carácter fuera del alfabeto se rechaza por su nombre en lugar de arruinarse en silencio.
Esa es también la razón por la que la aritmética detrás de esos seis dígitos arranca de una cadena en base32 y no en base64: el secreto tiene que sobrevivir a que una persona lo escriba, y el bit extra por carácter de base64 se desperdicia en un trabajo que se hace una sola vez, de viva voz o a mano, en lugar de millones de veces por una máquina.
¿Base32 es lo mismo en todos lados?
No, y aquí es donde la palabra "base32" se vuelve resbaladiza. Solo el RFC 4648 define dos alfabetos distintos bajo ese nombre:
- El alfabeto estándar —de la A a la Z y después del 2 al 7— es el que usan los secretos TOTP y la mayoría de las bibliotecas de base32 de propósito general.
- base32hex —del 0 al 9 y después de la A a la V— reordena los mismos 32 símbolos para que ordenar el texto codificado byte a byte dé el mismo orden que ordenar los bytes originales. Los registros NSEC3 de DNSSEC dependen exactamente de esa propiedad para demostrar que un nombre de dominio no existe sin tener que listar todos los que sí existen.
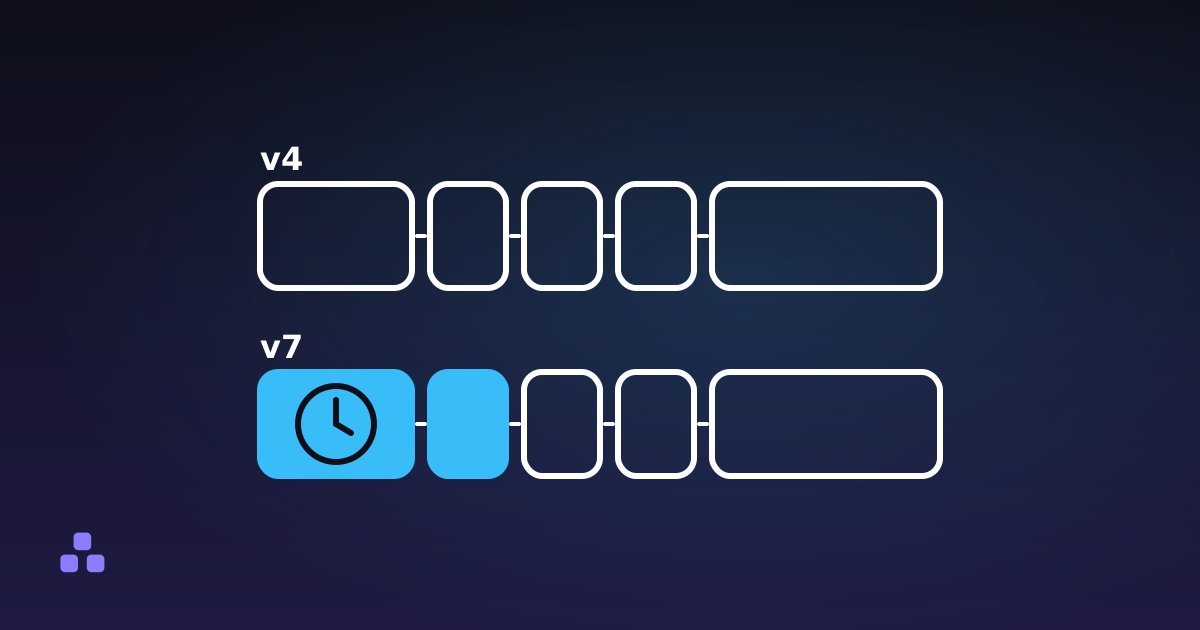
Fuera del RFC, el base32 de Crockford es un tercer diseño, incompatible con los otros dos: elimina por completo las letras I, L, O y U del alfabeto —la I y la L por parecerse al 1, la O por parecerse al 0, la U para evitar una palabra por accidente— y conserva los dígitos 0 y 1 en lugar de excluirlos como hace el RFC 4648. La decodificación es permisiva a propósito: una I o una L, en mayúscula o minúscula, se lee como 1, y una O se lee como 0. También define un símbolo de verificación opcional al final para detectar un carácter mal escrito, algo que el RFC 4648 no tiene de ninguna forma. ULID, un identificador ordenable emparentado con UUID v7, se escribe en base32 de Crockford —la misma idea del timestamp de 48 bits que UUID v7, solo que deletreada con otro alfabeto. Un software hecho para una variante de base32 no necesariamente lee la otra, así que conviene revisar el alfabeto antes de dar por hecho que dos cadenas "base32" son compatibles.
¿Dónde más aparece Base32?
Más allá de los secretos de dos factores, tres lugares que vale la pena reconocer:
- Las direcciones onion de Tor. Una dirección
.onionv3 es la clave pública Ed25519 de 32 bytes de un sitio, una versión de un byte y un checksum de dos bytes, todo pasado por base32 —por eso cada dirección onion mide exactamente 56 caracteres antes del sufijo.onion. - Los registros NSEC3 de DNSSEC, que guardan un nombre de dominio con hash usando base32hex justamente porque mantiene intacto el orden.
- Los ULID, en la variante de Crockford, en cualquier aplicación que quiera un identificador parecido a un UUID pero más corto de escribir y sin distinción de mayúsculas.
Lo que Base32 no puede hacer por ti
No es compresión: cinco bits de alfabeto por carácter significa que la forma codificada siempre es más grande que la entrada, nunca más chica. Tampoco es cifrado: igual que Base64, no tiene clave, y cualquiera que tenga una cadena base32 puede decodificarla en un paso, sin necesitar ningún secreto. Y no valida nada por sí solo: un secreto base32 corrompido, con un carácter cambiado por otro, sigue decodificándose en 20 bytes, solo que los 20 bytes equivocados, y nada en el formato mismo avisa que eso pasó. Solo el símbolo de verificación opcional de Crockford resuelve eso, y el base32 del RFC 4648 —el que hay detrás de tu secreto de dos factores— no tiene nada parecido.
La herramienta más directamente relacionada con todo esto es el generador de TOTP: pega un secreto en base32 y decodifica el alfabeto delante de ti, con cantidad de bytes incluida, la misma decodificación que hace una app de autenticación de verdad antes de tocar siquiera el HMAC. No se sube ni se guarda nada: recarga la página y el secreto desaparece.
Si los seis dígitos que salen del otro lado son la parte que en realidad querías que te explicaran, cómo se calculan esos códigos a partir del secreto decodificado continúa justo donde termina este posteo.
Preguntas frecuentes
¿Para qué se usa Base32?
Principalmente para valores que una persona podría tener que escribir, leer en voz alta o comparar a simple vista: secretos de autenticación de dos factores, direcciones onion de Tor e identificadores ordenables como ULID. En cualquier lugar donde un valor solo lo vaya a leer una máquina, Base64 suele ser mejor opción, porque mete más información en menos caracteres.
¿Base32 distingue mayúsculas de minúsculas?
El RFC que lo estandariza apunta a un formato que no necesite conservar la diferencia entre mayúsculas y minúsculas, así que un codificador conforme siempre produce mayúsculas y un decodificador bien hecho también acepta minúsculas. No todas las implementaciones son igual de permisivas, así que si una cadena Base32 es rechazada, vale la pena probarla en mayúsculas antes de asumir que el valor está mal.
¿Por qué una cadena Base32 es más larga que la Base64 equivalente?
Porque cada carácter de Base32 lleva 5 bits de información contra los 6 de Base64, así que los mismos datos necesitan alrededor de un 20% más de caracteres en Base32. Un secreto de 20 bytes sale como 32 caracteres en Base32 o 27 en Base64: el precio de un alfabeto pensado para sobrevivir a que lo copien a mano y no a que lo lea un parser.
¿Cuál es la diferencia entre el Base32 estándar y el Base32 de Crockford?
El Base32 estándar, del RFC 4648, usa de la A a la Z y del 2 al 7, y conserva todas las letras, incluidas las que se parecen a dígitos. El Base32 de Crockford, el que usan identificadores como ULID, hace lo contrario: conserva el 0 y el 1 pero elimina las letras I, L, O y U, y su decodificador perdona automáticamente algunas confusiones habituales. Los dos alfabetos no son intercambiables.
¿Se puede corregir automáticamente una cadena Base32 si un carácter está mal escrito?
Solo si el software usa la variante de Crockford, que traduce de vuelta unos pocos caracteres que suelen escribirse mal y admite un carácter de verificación opcional para detectar el resto. El base32 del RFC 4648 —el que hay detrás de un secreto de dos factores— no tiene ninguna de las dos cosas: un carácter equivocado se rechaza directamente o se decodifica en silencio en los bytes que no son.
Última actualización 27 de septiembre de 2026